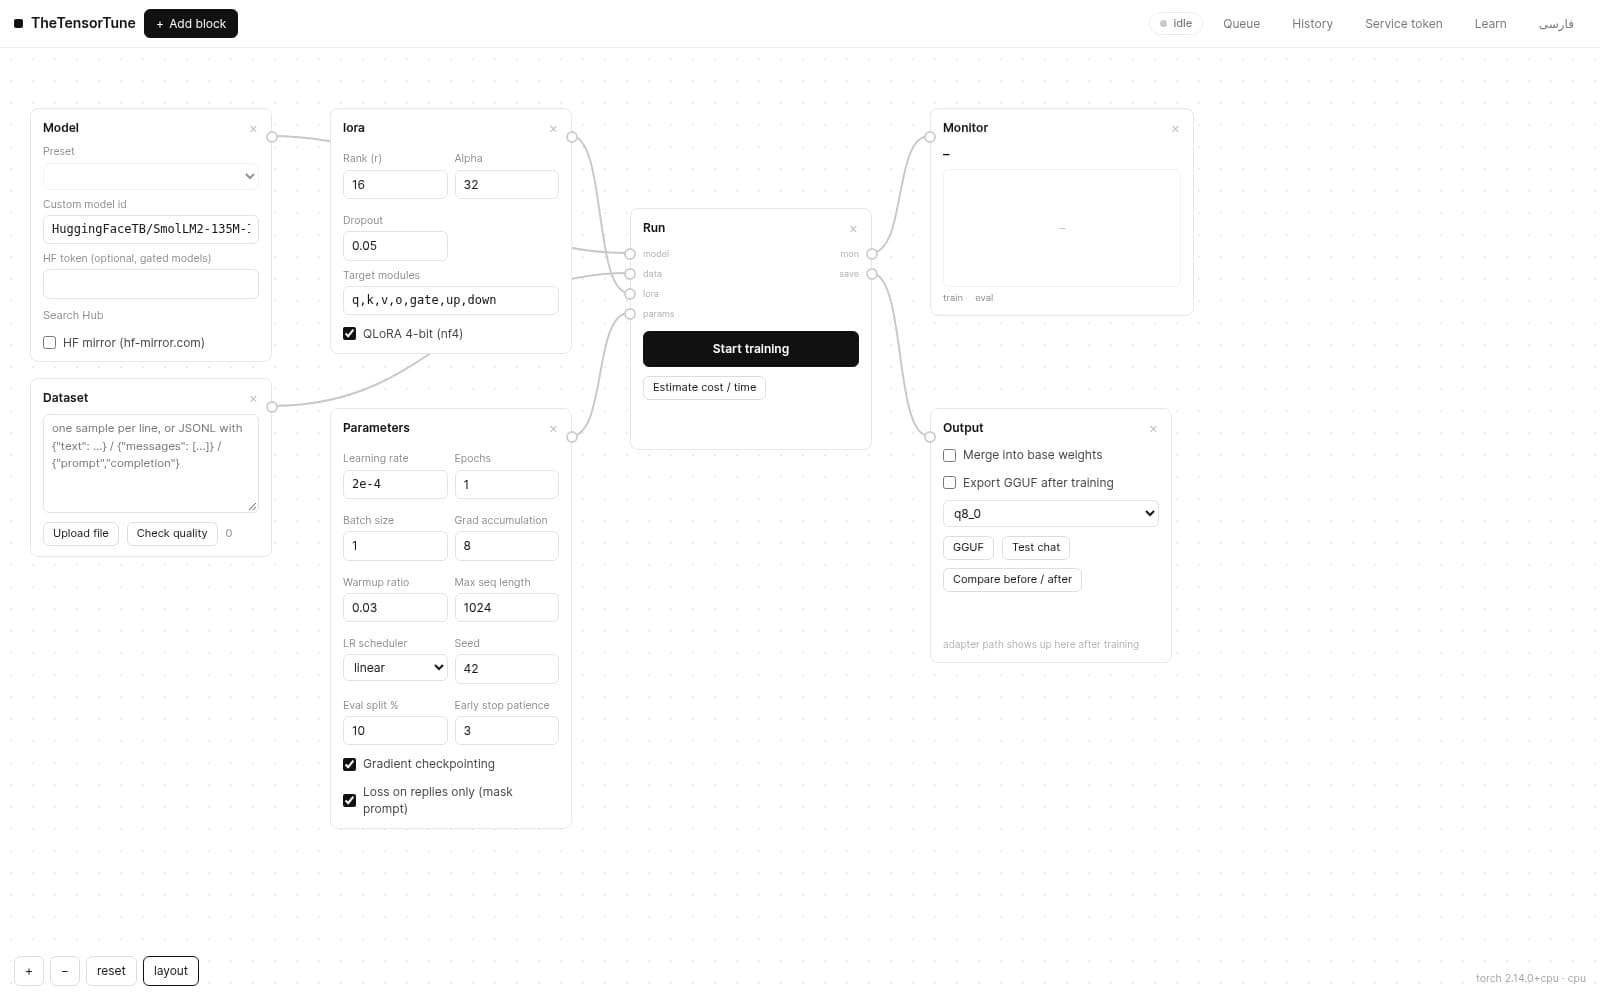
Die GGUF-Taste am Ausgabe-Block (oder in einer Lauf-Zeile der Historie) merged das Modell und schreibt eine .gguf-Datei neben den Lauf — bereit für llama.cpp / Ollama / LM Studio:
- quant:
f16(exakt, groß),q8_0(geringer Fehler, schlank — empfohlen) und K-Quants wieq4_k_m(brauchen llama-quantize im PATH oder via TT_LLAMA_CPP). - Der Export-Fortschritt erscheint im Dialog; am Ende gibt es Dateipfad und Download.
- Die Metadaten bleiben intakt: Tokenizer, Architektur und Attention-Biases werden erhalten — die Antworten des Exports entsprechen dem Quellmodell.
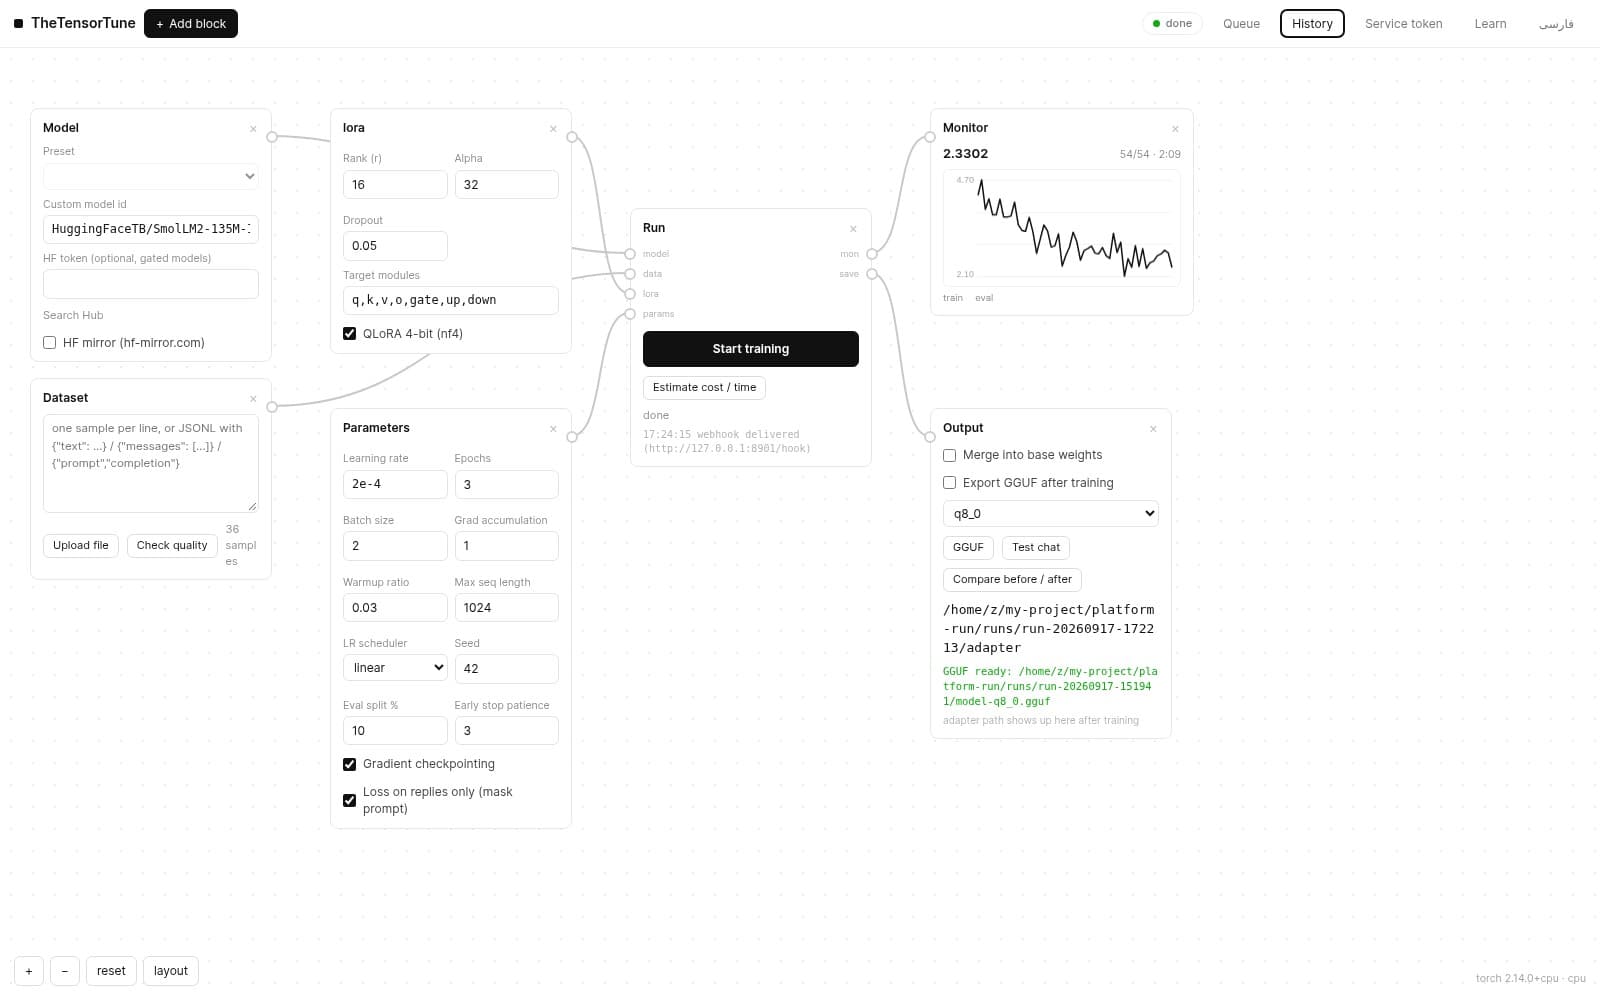
Tipp: Ein q8_0-Export liefert Antworten, die dem Quellmodell entsprechen — Tokenizer, Architektur und Attention-Einstellungen bleiben erhalten.