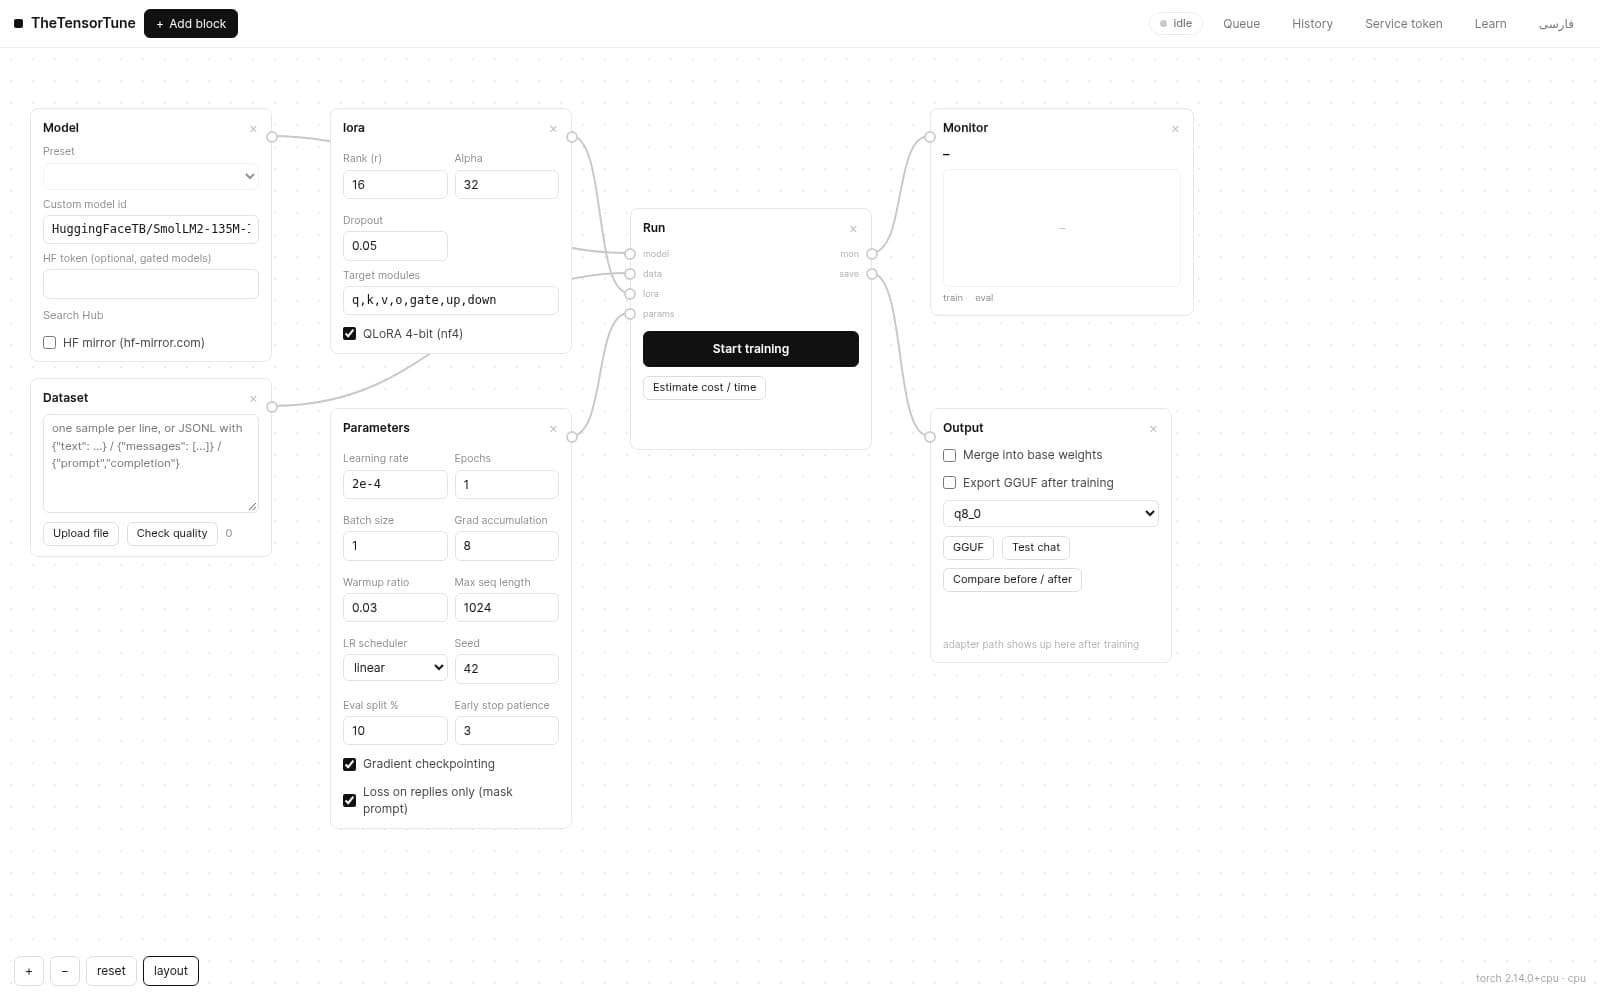
Der LoRA-Block bestimmt, welcher Teil des Modells mit welcher Kapazität trainiert. Die Basisgewichte bleiben eingefroren; nur die niederrangigen Matrizen lernen — deshalb bleiben Speicher- und Plattenbedarf klein.
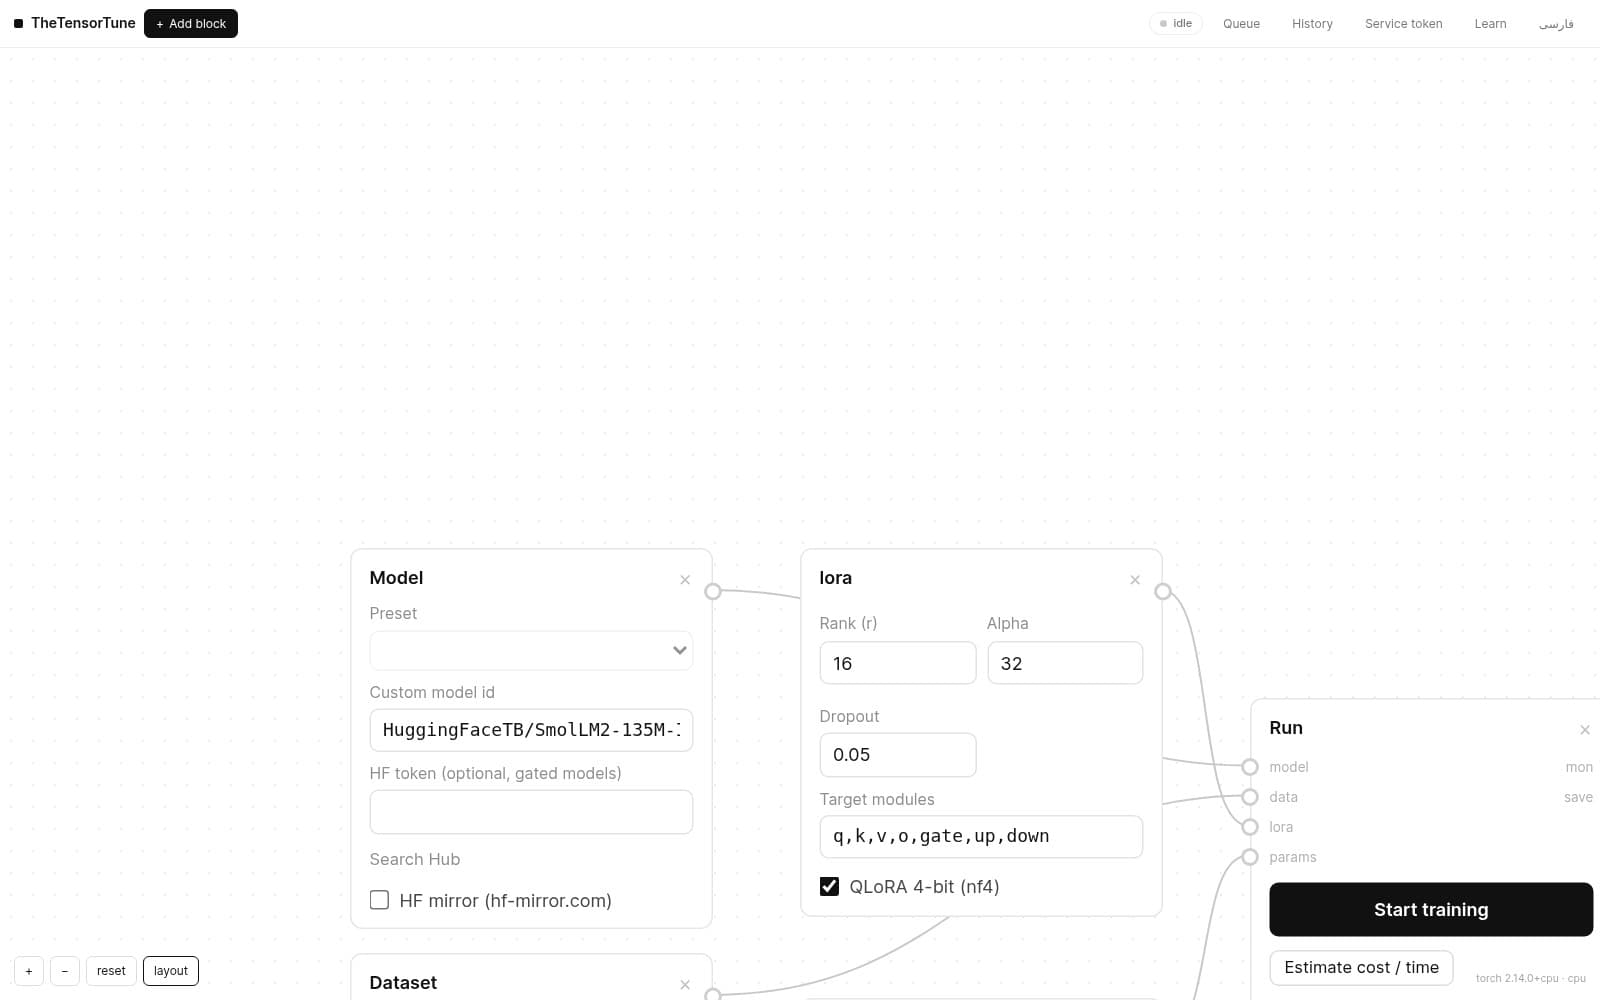
- rank (r): Trainingskapazität; 8 für leichte Stilaufgaben, 16–32 für reichhaltigeres Verhalten. Größeres r = größerer Adapter.
- alpha: Ausgabeskalierung des LoRA-Pfads; die gängige Konvention ist
alpha = 2×r. - dropout: 0,05 ist typisch und hilft bei kleinen Datensätzen.
- targets: Attention-Projektionen (q,k,v,o) plus MLP (gate,up,down) — ein solider Standard.
- QLoRA: lädt das Basismodell in 4 Bit (NF4), damit größere Modelle in weniger Speicher passen.
Tipp: Mit dem 0,5B-Modell und r=8 trainieren Sie ~4–9 Mio. Parameter — die finale Adapterdatei ist einige Dutzend Megabyte groß.