Ein Datensatz ist ein Versprechen
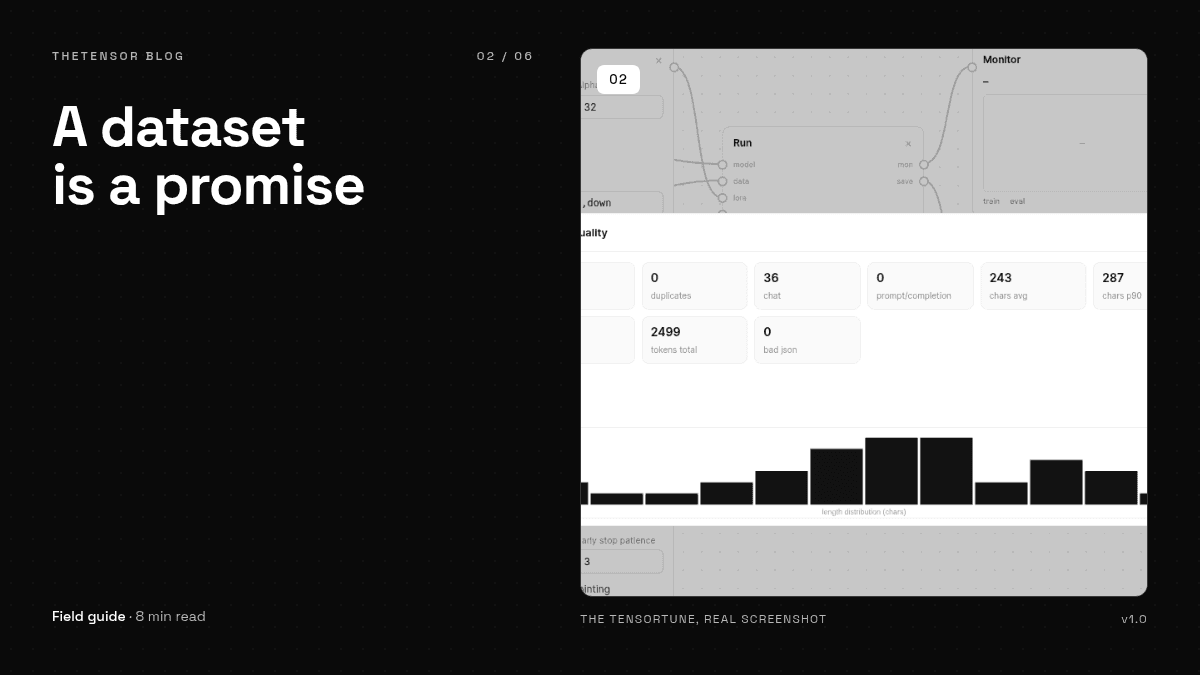
Was Sie in einen Finetuning-Datensatz legen, ist das Versprechen, das das Modell einlösen wird. Formate, realistische Größen und wie man den Qualitätsbericht liest, bevor man auch nur eine Epoche an schlechten Daten verschwendet.
Niemandes Finetuning ist am falschen Dropout gescheitert. Vieler ist an einem Datensatz gescheitert aus zwanzig beinahe identischen Samples und einem vierzigtausend-Zeichen-Roman. Das ist die kurze, meinungsstarke Version dessen, was wir beim Bau des Dataset-Blocks und seines Qualitätsberichts gelernt haben — plus das Denkmodell, das alles an seinen Platz rückt: Ein Datensatz ist ein Versprechen. Jedes Sample sagt dem Modell „antworte so“. Wenn die Samples einander widersprechen — oder dem, was Sie eigentlich wollen —, wird das Modell dieses kaputte Versprechen treu einlösen.
Drei Formate, drei Absichten
- Chat —
{"messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}]}. Das empfohlene Standardformat. Trainiert werden nur die Assistant-Runden: Das Modell lernt Antworten, nicht Fragen. - Prompt / Completion —
{"prompt":"...","completion":"..."}. Für Transformationsaufgaben: korrigiere diesen Text, klassifiziere das, kürze das auf. - Freier Text —
{"text":"..."}oder jede beliebige Zeile. Für Stiltransfer auf rohem Text. Keine Struktur wird auferlegt; Konsistenz ist ganz Ihre Aufgabe.
Das Format ist keine Formalität — es entscheidet, welches Versprechen Sie geben. Chat-Samples lehren ein Modell, auf jemanden zu antworten. Prompt/Completion lehrt es, eine bestimmte Transformation auszuführen. Freier Text lehrt es, zu klingen. Sorglos in einen Datensatz gemischt, verschmieren sie zu einem Versprechen, das das Modell nicht halten kann — deshalb zeigt der Qualitätsbericht den Format-Mix vor dem Training.
Wie groß? Kleiner als Sie denken
Das Internet deutet an, man brauche tausende Samples. Mit LoRA stimmt das schlicht nicht. Zwanzig bis wenige hundert gut gewählte Samples können Ton und Format dramatisch bewegen — genau das ist der Reiz der Methode. Unser Demo-Datensatz sind sechsunddreißig Chat-Samples eines erfundenen Support-Agenten eines Internetanbieters, und am Ende des Trainings unterzeichnete das Modell jede Antwort mit derselben Grußformel und antwortete in demselben knapp-freundlichen Tonfall. Was zählt, ist nicht Masse. Konsistenz: Samples, die darin übereinstimmen, wer spricht. Abdeckung: die Situationen, die Sie abgedeckt haben wollen. Ehrlichkeit: Antworten, die das vertreten, was Sie wirklich wollen — nicht das, was Sie sich wünschten zu sagen.
Den Qualitätsbericht lesen
Drücken Sie Qualität prüfen, und der Bericht liefert Fakten; vier davon verdienen den ersten Blick.
- Duplikate — der schnellste Weg zu einem Modell, das eine Sache sagt, perfekt, immer. Vor dem Training deduplizieren.
- Längen-Histogramm — Samples jenseits von
maxlenwerden abgeschnitten. Wohnt Ihre Daten am rechten Ende des Diagramms, erhöhen Sie maxlen oder teilen Sie die Samples. - Sprach-Mix — erkannte Sprachen, Persisch und Emojis inklusive. Eine überraschende Sprache bedeutet meist einen Einfügefehler.
- Format-Mix — was als Chat geparst wurde, was als Prompt/Completion, was auf freien Text zurückfiel. Stille Fallbacks sind die Quelle der Trainingsüberraschungen.
Der Eval-Split: Halten Sie ein Versprechen an sich selbst
Setzen Sie eval_pct zwischen 10 und 20, und die saubersten Samples werden Ihr Beweismaterial. Der Vergleichsbildschirm misst die Perplexität auf Daten, auf denen das Modell nie trainiert hat — der einzige ehrliche Weg festzustellen, ob die Abstimmung griff. Eval-Split null klingt verlockend — mehr Daten! — aber überlässt Sie einem Bauchgefühl. Der Sinn der ganzen Übung ist, Gefühle durch Zahlen zu ersetzen, und das hier ist die billigste Zahl auf der Karte.