Wie man eine Loss-Kurve liest
Ein Loss-Diagramm ist der direkteste Blick auf einen Trainingslauf. Wie eine gesunde Kurve aussieht, wie ein Lernraten-Blow-up aussieht, wie man Overfitting früh erkennt und wozu der Eval-Split wirklich gut ist.
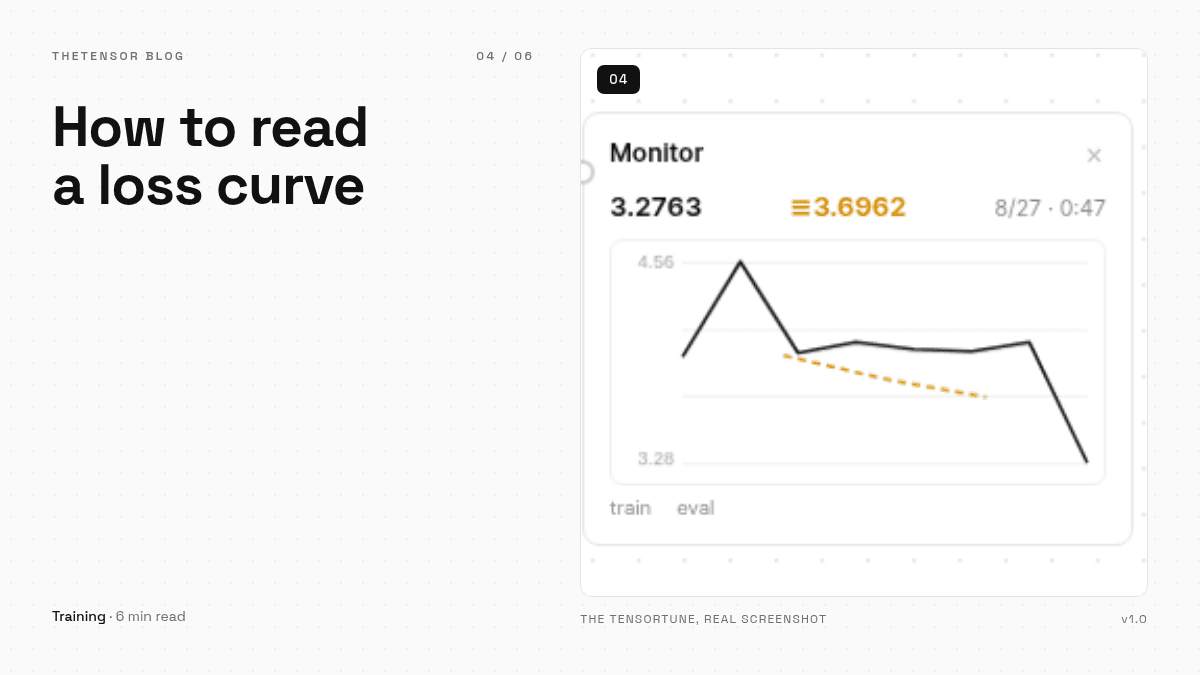
Wenn Sie in TheTensorTune auf Start drücken, beginnt der Monitor-Block, eine Linie zu zeichnen. Diese Linie ist das dichteste Informationsstück der ganzen App, und den meisten Leuten wird nie beigebracht, was sie damit anfangen sollen. Eine Loss-Kurve ist keine Punktzahl, sondern ein vollständiger Bericht des Laufs — und wenn Sie die vier, fünf Plots kennt, die sie erzählen kann, lesen Sie einen Lauf auf einen Blick.
Was die Linie wirklich ist
Loss ist das Überraschtsein des Modells. In jedem Trainingsschritt nimmt das Modell einen Batch Ihrer Samples, rät das nächste Token und misst, wie falsch es lag. Hoher Loss: sehr falsch. Niedriger Loss: Es hat Ihre Antwort kommen sehen. Training bedeutet, ein paar Millionen Zahlen so zu schieben, dass die Überraschung beim nächsten Mal kleiner ausfällt. Das Diagramm im Monitor zeichnet einen Punkt pro Schritt, plus eine zweite, gestrichelte Linie für den Eval-Split — den Anteil Ihrer Daten, auf dem das Modell nie trainiert und der als ehrliche Prüfung zurückgelegt wird.
Der gesunde Plot
Eine gesunde Kurve fällt zuerst schnell und flacht dann ab, wenn sie sich einem Boden nähert. In einem unserer Demo-Läufe — ein kleines Instruct-Modell auf sechsunddreißig Support-Agent-Samples — fiel der Trainings-Loss über neunzig Schritte von etwa 4.0 auf 1.4, und der Eval-Loss folgte. Diese Form bedeutet: Das Modell lernt die Muster der Daten, nicht deren exakte Worte, denn die Eval-Samples wurden ihm nie gezeigt. Wenn die gestrichelte Linie der durchgezogenen nach unten folgt, glauben Sie dem Lauf.
Der Blow-up
Manchmal fällt die Kurve nicht — sie steigt, oder sie zerbricht in ein Zackenmuster, das mit jedem Schritt schlechter wird. Das ist fast immer die Lernrate. Die Lernrate ist die Größe des Schubs: zu klein, und nichts passiert; zu groß, und jeder Schritt schießt übers Ziel, das Modell wird schlechter statt besser. Wir haben beim Testen einmal 1.0 eingestellt (nicht nachmachen) und dabei gesehen, wie der Loss steil nach oben schoss. Für LoRA ist 2e-4 der gut getestete Standard. Wenn Ihre Kurve hochgeht: runter damit und neu starten — ein verbrannter Lauf ist nicht wert, gerettet zu werden.
Die stille Lüge: Overfitting
Der heimtückischere Plot: Die durchgezogene Linie fällt weiter, aber die gestrichelte dreht und klettert. Das Modell speichert Ihre Trainingssamples Wort für Wort, und seine Leistung auf ungesehenen Daten wird schlechter. Auf kleinen Datensätzen — das sind die meisten, mit denen Menschen finetunen — passiert das nach ein paar Epochen. Es ist keine Katastrophe, es ist Information: Entweder hier aufhören oder die Epochen reduzieren. TheTensorTunes Early Stopping beobachtet die Eval-Linie für Sie und hält einen Lauf an, der sich nicht mehr verbessert.
Eine weitere Zahl hat sich ihren Platz auf dem Bildschirm verdient: die Perplexität, die der Vergleichsbildschirm für Basis- und getuntes Modell meldet. Es ist der Loss, übersetzt in „zwischen wie vielen Wörtern das Modell im Schnitt gerungen hat“ — je niedriger, desto sicherer. Zu sehen, wie sie auf dem Eval-Split unseres Demo-Datensatzes von 55 unter 9 fiel, war befriedigender als jede Loss-Zahl, denn sie wurde auf Daten gemessen, auf denen das Modell nie trainiert hatte. Das ist der ganze Sinn des Eval-Splits: Er verwandelt ein Gefühl in eine Zahl.