LoRA, verständlich
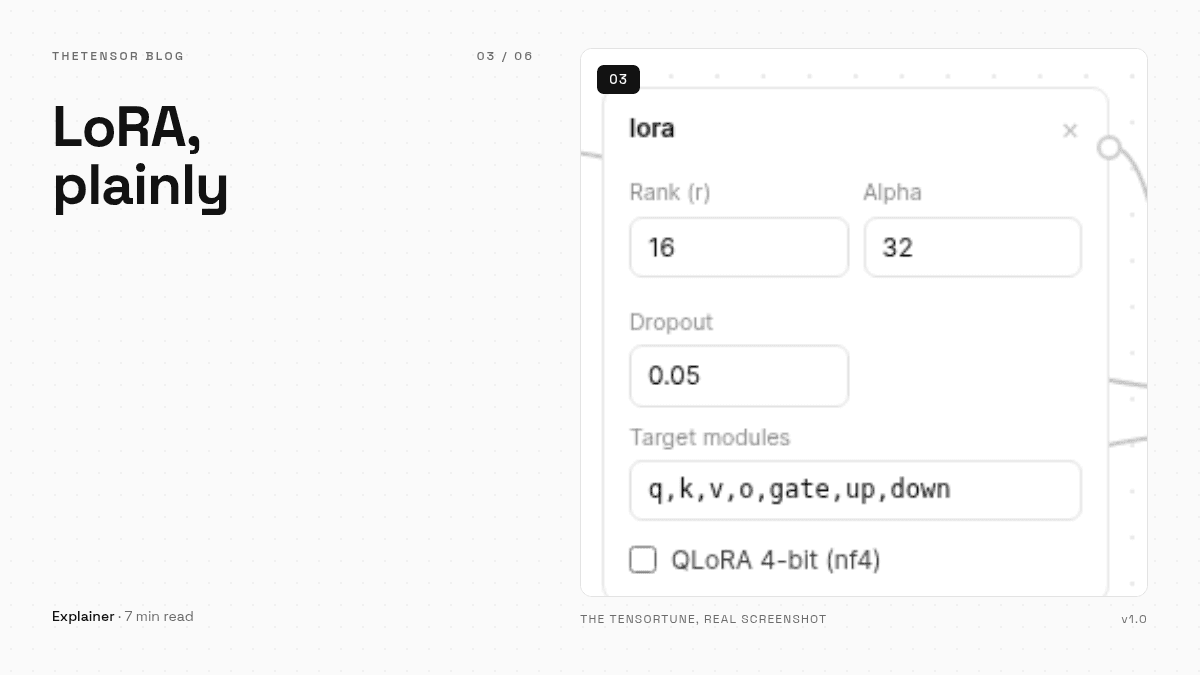
Was LoRA wirklich tut, ohne Mathe-Kopfschmerzen: eingefrorene Basisgewichte, ein dünn trainierbares Overlay, und was Rank, Alpha, Dropout und Ziel-Layer jeweils bewirken — plus wann sich QLoRA lohnt.
LoRA wird üblicherweise mit Matrizen, Rang-Zerlegungen und einem Haufen Notation erklärt. Das ist nützlich, wenn Sie es implementieren, und nutzlos, wenn Sie heute Nachmittag ein Modell feintunen wollen. Hier ist die Arbeitsversion — die, die neben den echten Feldern des LoRA-Blocks Platz findet.
Die Kernidee in einem Absatz
Vollständiges Finetuning schreibt jedes Gewicht des Modells neu — Milliarden Zahlen, Gigabytes an Gradienten. LoRA geht eine andere Wette: Friere die Originalgewichte vollständig ein und trainiere daneben ein kleines Paar Matrizen, dessen Produkt die gewünschte Änderung annähert. Das Modell bleibt unangetastet. Ihr Training schreibt ein dünnes Overlay, und genau dieses Overlay wird gespeichert. Deshalb braucht ein LoRA-Lauf einen Bruchteil des Speichers, und deshalb ist das Ergebnis eine Adapter-Datei von Dutzenden Megabytes statt einer vollständigen Modellkopie.
Rank: wie viel das Overlay sagen darf
Der Rank (r) ist die Breite dieser Matrizen — die Zahl unabhängiger Richtungen, die das Overlay ausdrücken kann. Rank 8 gibt ein kompaktes Overlay für Ton-, Format- und Stilverschiebungen. Rank 16 bis 32 erkauft Raum für reichhaltigeres Verhalten, zum Preis eines größeren Adapters und etwas mehr Speicher. Auf einem kleinen Modell mit r=16 trainieren Sie grob ein paar Millionen Parameter — rund ein Prozent des Modells. Dieses Verhältnis ist der ganze Trick: winziges Overlay, unangetastete Basis.
Alpha: wie laut es spricht
Alpha skaliert, wie stark der Beitrag des Overlays in die Ausgabe des Modells gemischt wird. Die Konvention der Community ist alpha = 2 × r, weshalb die Paare 8/16 und 16/32 überall auftauchen, auch bei uns. Die Feinheit, die man kennen sollte: Es kommt auf das Verhältnis alpha / r an, nicht auf eine der Zahlen allein. Halten Sie das Verhältnis um zwei, und Sie liegen kaum falsch. Wenn Sie eines Tages experimentieren wollen, ist genau dieses der Regler, den Sie drehen.
Dropout und Ziel-Layer
Dropout (0.05 ist ein guter Standard) bringt während des Trainings zufällige Teile des Overlays zum Schweigen, damit es Ihren Datensatz nicht Wort für Wort auswendig lernt. Am meisten bringt er bei kleinen Datensätzen — die, realistisch gesprochen, die meisten sind, mit denen Menschen finetunen.
Ziel-Layer entscheiden, wo sich das Overlay einklinkt. Der Standard-Satz deckt die Attention-Projektionen (q, k, v, o) plus den MLP-Block (gate, up, down) ab — das Standardrezept, mit dem TheTensorTune ausgeliefert wird. Ein engerer Satz trainiert schneller, lernt aber weniger; der Standard ist die langweilige, verlässliche Wahl, und langweilig ist auf diesem Gebiet ein Kompliment.
QLoRA: dieselbe Idee, kleinere Schachtel
QLoRA behält alles oben Genannte, lädt aber das eingefrorene Basismodell in 4 Bit (NF4) statt in voller Genauigkeit, sodass ein Modell, das viel Speicher brauchte, in einen Bruchteil passt. Sie trainieren dasselbe Overlay; die Basis beansprucht nur weniger Platz, während Sie es tun. Es ist ein Schalter im LoRA-Block statt ein Standard, denn auf kleinen Modellen kauft die Kompression weniger ein, als sie kostet. Schalten Sie es ein, wenn das Modell, das Sie wollen, größer ist als der Platz, den Sie haben.
Das war LoRA ohne eine einzige Matrix: eine Rank-Zahl, ein Lautstärkeregler, etwas Dropout und ein vernünftiger Satz Layer. Setzen Sie r, verdoppeln Sie für Alpha — und wenden Sie die restliche Aufmerksamkeit dem Datensatz zu. Dort werden Finetunings gewonnen.