Warum wir TheTensorTune gebaut haben
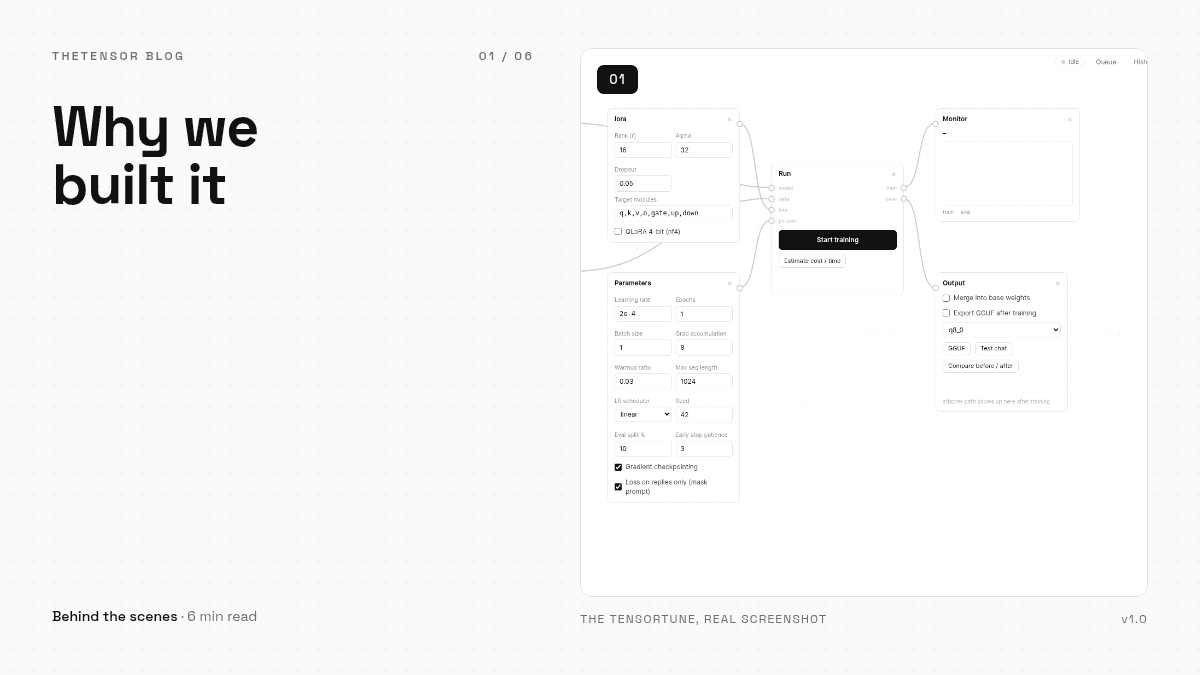
Die ehrliche Geschichte hinter TheTensorTune: Was uns an bestehenden Finetuning-Tools genervt hat, warum alles in eine Python-Datei musste und was in v1.0 gelandet ist.
Jedes Finetuning-Tutorial beginnt gleich: Klone das Repo, installier diese vierzehn Dinge, kopier die yaml, beheb den Versionskonflikt, bearbeite noch drei Dateien — und bekommst dann, wenn nichts kaputtgegangen ist, einen Fortschrittsbalken und keinerlei Ahnung, was es mit deinen Daten macht. Wir haben diese Tutorials öfter verfolgt, als wir zählen können. Etwa bei der fünften zerstörten Umgebung hörte die Idee zu TheTensorTune auf, ein Witz zu sein.
Das Ziel war nie, mit den großen Trainings-Frameworks zu konkurrieren — die sind gut in ihrem Job. Das Ziel war, die Standardschleife — Datensatz, Modell, LoRA-Einstellungen, Training, Evaluation, Export — in etwas zu verwandeln, das man von Anfang bis Ende sehen und anfassen kann, ohne den Browser-Tab zu verlassen. Finetuning ist kein seltenes Ritual mehr; für viele ist es eine ganz gewöhnliche Aufgabe, und es verdiente eine Werkbank statt einer Checkliste.
Eine Datei, absichtlich
Die Einschränkung klang albern, als wir sie aufschrieben: Die ganze App ist eine einzige Python-Datei. Keine Paketstruktur, kein Build-Schritt, kein Container-Image. Der Grund ist praktisch. Eine einzelne Datei ist leicht zu lesen, leicht zu auditieren, leicht auf einen USB-Stick zu ziehen und einer Kollegin zu reichen. Wenn jemand fragt „was macht das eigentlich mit meinen Daten?“, kann die Antwort lauten: „Öffne die Datei und schau nach“ — und diese Antwort passt tatsächlich in einen Nachmittag Lektüre.
Die Einschränkung hielt uns auch ehrlich, was den Umfang angeht. Jedes Feature musste sich seinen Platz in der Datei verdienen. Wofür ein Microservice oder ein Datenbankserver nötig gewesen wäre, flog raus. Überlebt hat die Schleife, die Sie heute sehen: eine Leinwand aus verdrahteten Blöcken, eine Datensatz-Qualitätsprüfung, Training mit Live-Kurven, eine Queue mit Checkpoints, Test-Chat, Vorher-nachher-Vergleich und GGUF-Export. Jedes einzelne beantwortet eine Frage, die Menschen beim Finetuning wirklich haben.
Was in 1.0 gelandet ist
- Die Werkbank — eine Node-Graph-Leinwand, auf der jede Phase ein Block ist, auf Englisch und vollständigem Persisch von rechts nach links.
- Echtes Training — PEFT unter der Haube, mit Checkpoints, Fortsetzen und Early Stopping.
- Antworten statt Artefakte — Test-Chat und Side-by-Side-Vergleich, denn ein Modell, mit dem man nicht reden kann, ist eine Datei, kein Ergebnis.
- Ein Export, der läuft — Merge und Quantisierung zu GGUF in einem Klick, bereit für Ollama und llama.cpp.
- Ein Kurs in der App — zwölf Lektionen mit Screenshots, vom ersten Upload bis zur API-Automatisierung.
Vor dem 1.0-Tag durchlief das Release fünfzig Testszenarien — dreißig funktionale, zwanzig End-to-End — plus eine Sicherheitsregressionssuite, die Path Traversal, SSRF, XSS, CSRF, Token-Handhabung und Upload-Härtung abdeckt. Dieser Teil machte keinen Spaß, und wir würden ihn nie streichen. Ein Tool, das Ihre Dateien berührt und einen lokalen Server betreibt, muss an genau den richtigen Stellen langweilig sein.
Wenn Sie bereits Modelle feintunen, dürfte sich die Werkbank wie die Abkürzung anfühlen, die Ihnen gefehlt hat. Und wenn Sie es noch nie getan haben: Lektion eins startet bei null und führt Sie Schritt für Schritt. So oder so — sagen Sie uns, was kaputtgeht. Die Links stehen im Footer.