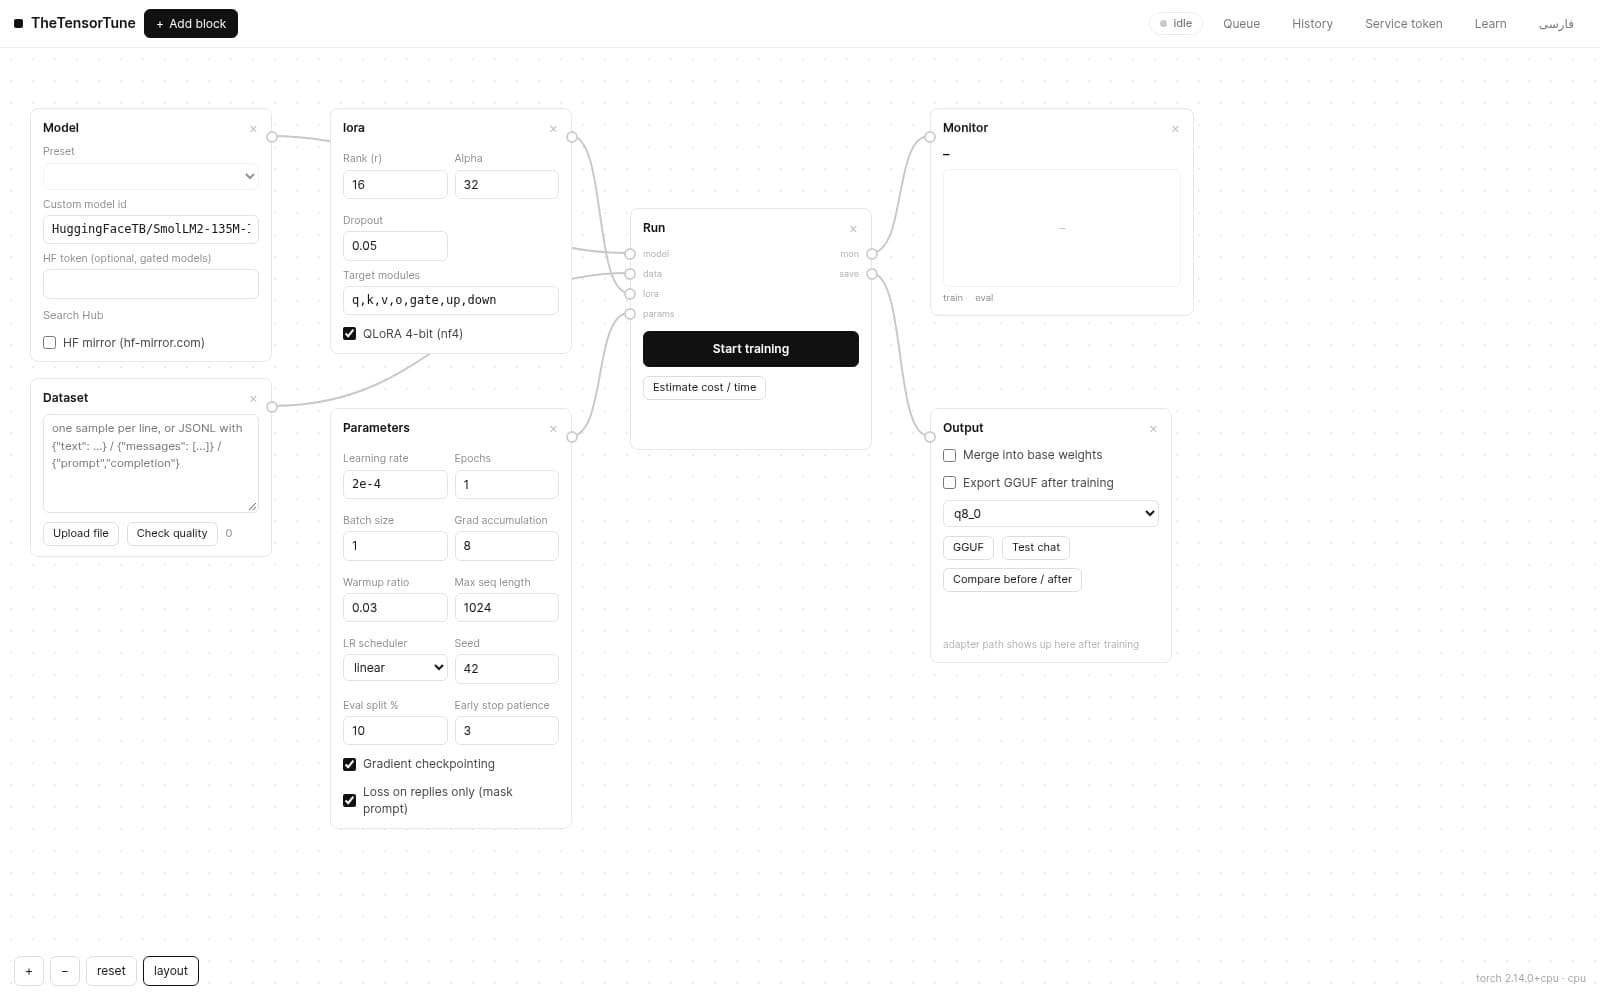
دکمهی GGUF روی بلوک خروجی (یا ردیف run در تاریخچه) مدل را merge کرده و فایل .gguf در کنار run مینویسد — آمادهی llama.cpp / Ollama / LM Studio:
- quant:
f16(دقیق، حجیم)،q8_0(کمخطا و سبک — پیشنهادی) و K-quants مثلq4_k_m(نیازمند llama-quantize در PATH یا متغیر TT_LLAMA_CPP). - پیشرفت export در همان مودال دیده میشود و پس از پایان، مسیر فایل و دانلود داده میشود.
- metadata سالم است: tokenizer، معماری و بایاسهای توجه بدون تغییر نگه داشته میشوند و پاسخ مدل export شده با مدل اصلی سازگار است.
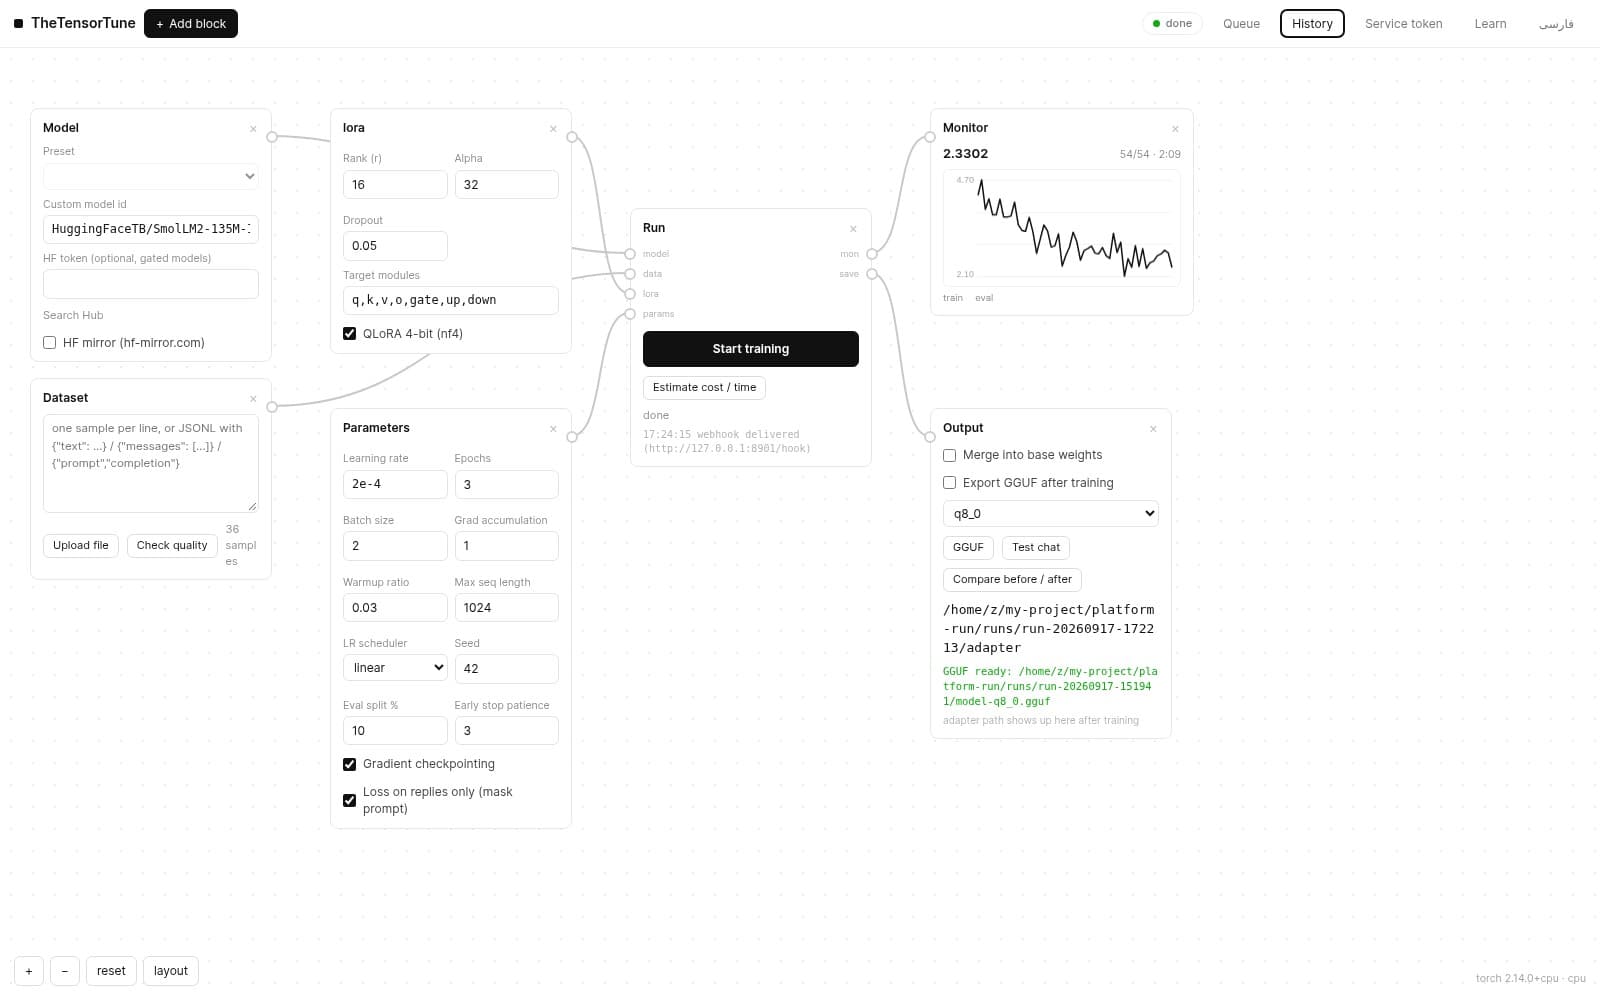
نکته: خروجی q8_0 پاسخهایی همسان با مدل اصلی میدهد — توکنایزر، معماری و تنظیمات attention همه حفظ میشوند.