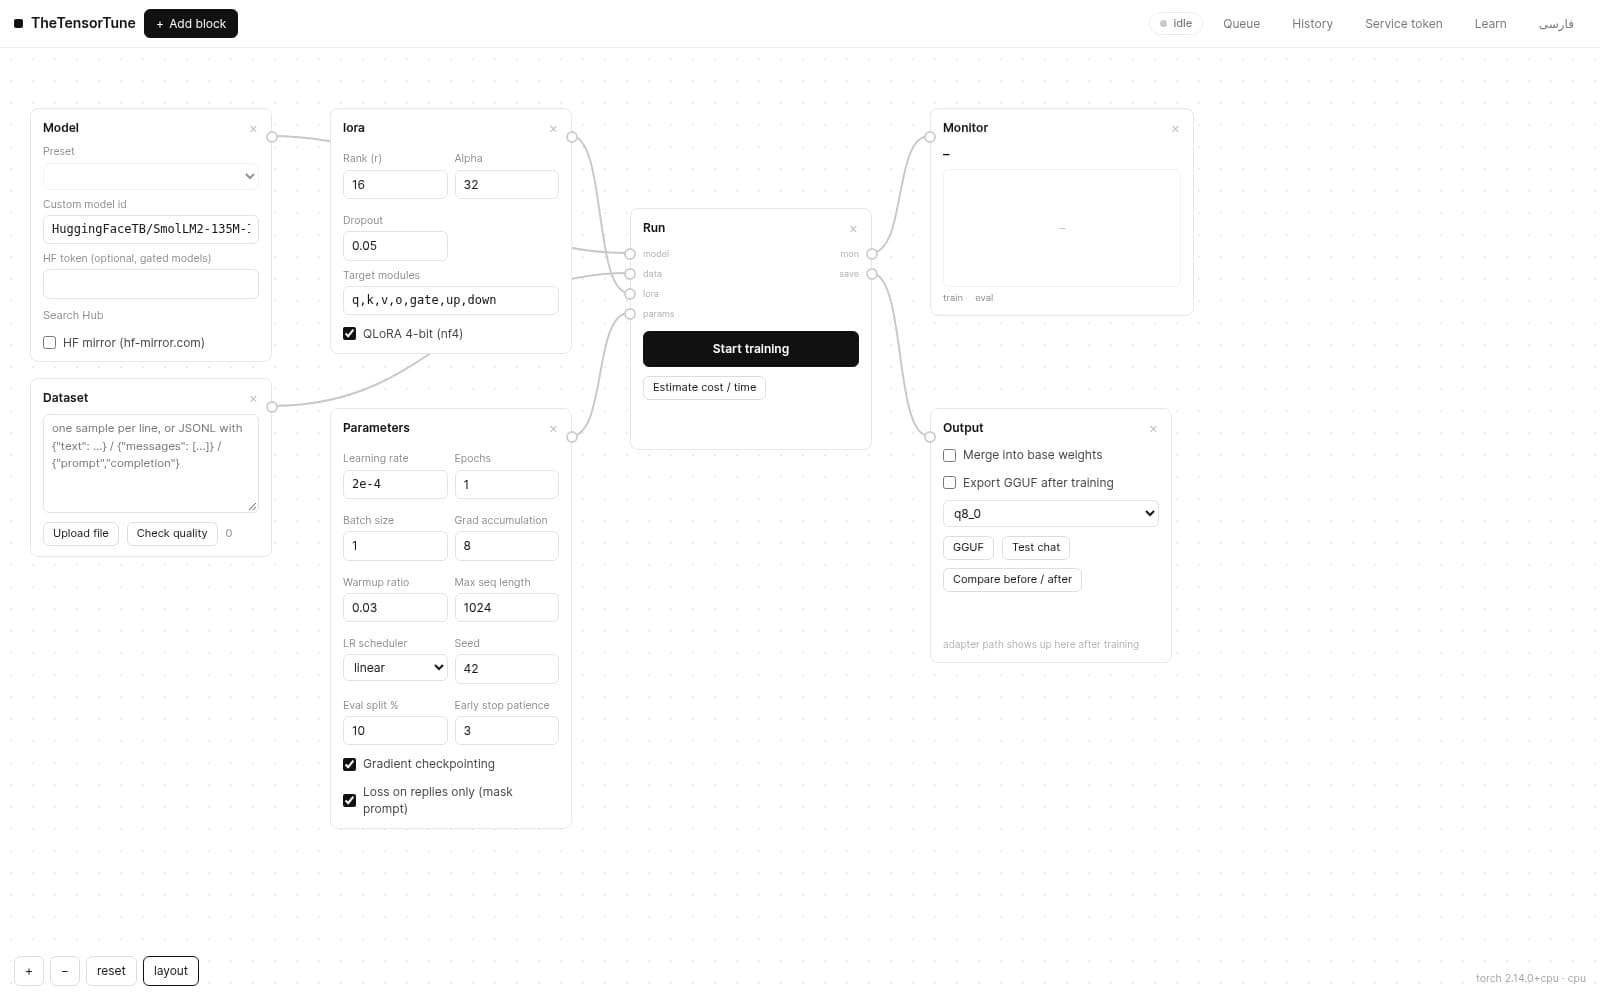
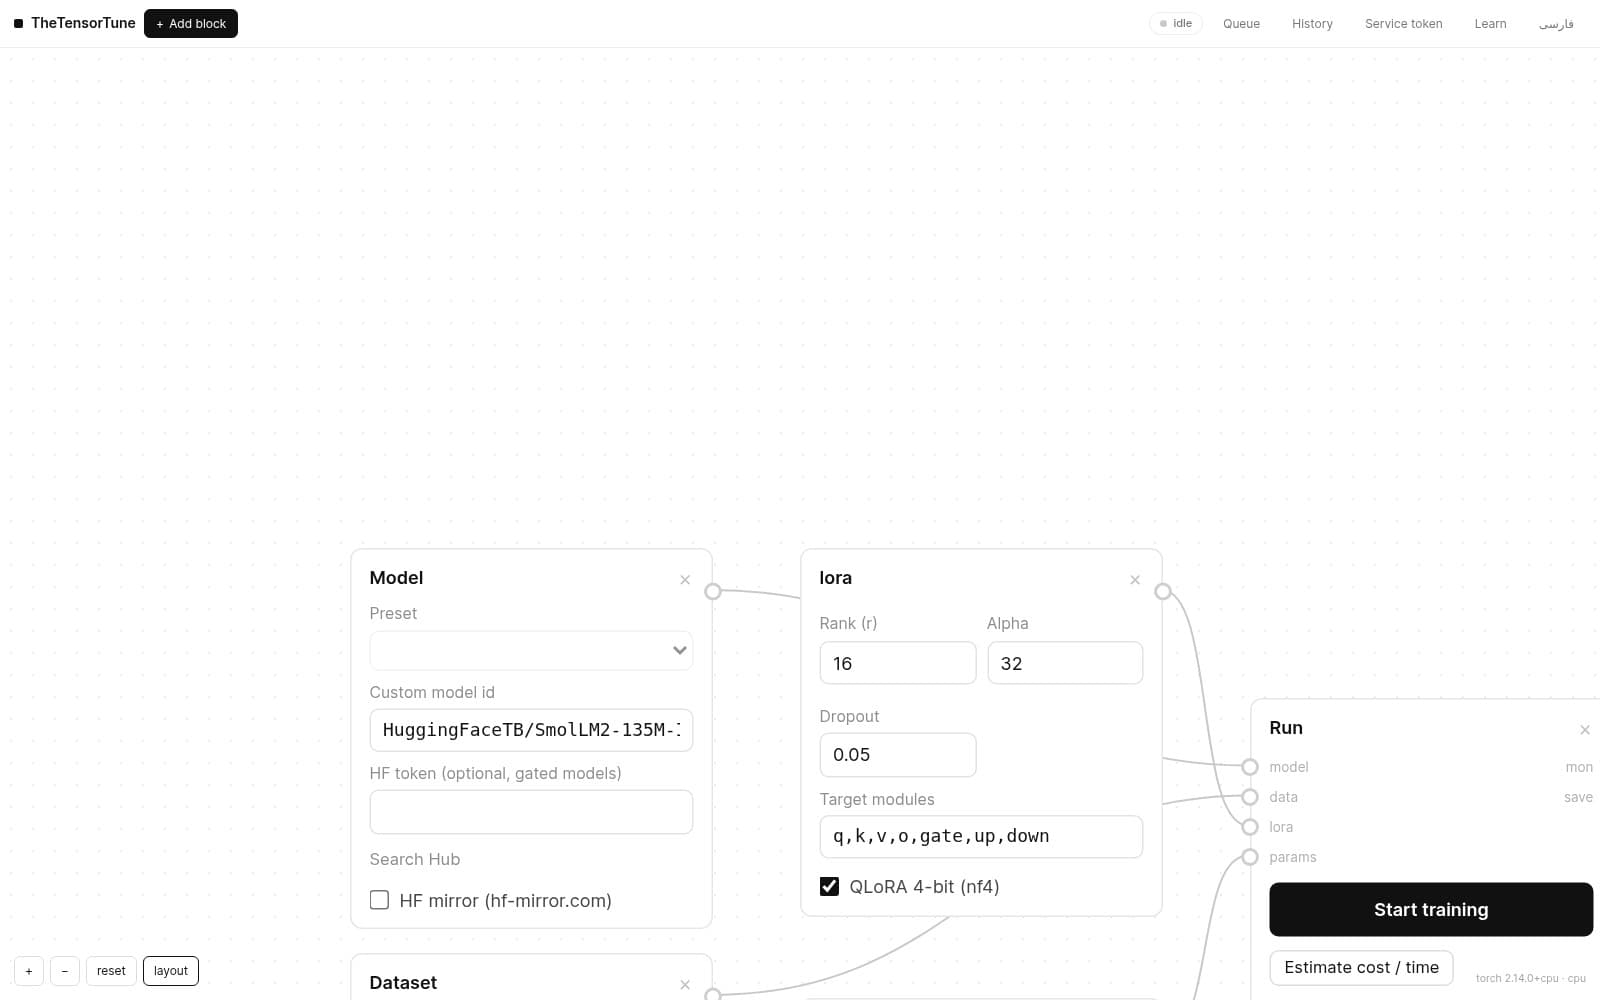
بلوک LoRA مشخص میکند چه بخشی از مدل و با چه ظرفیتی آموزش ببیند. وزنهای اصلی مدل ثابت میمانند و فقط ماتریسهای کمرتب (low-rank) یاد میگیرند — به همین دلیل حافظه و دیسک بسیار کمتری لازم است.
- rank (r): ظرفیت آموزش؛ ۸ برای وظایف ساده و سبک، ۱۶–۳۲ برای رفتارهای پیچیدهتر. مقادیر بزرگتر = Adapter بزرگتر.
- alpha: مقیاس خروجی LoRA؛ قرارداد رایج
alpha = 2×rاست. - dropout: ۰٫۰۵ معمول است؛ برای دیتاستهای کوچک کمک میکند.
- targets: لایههای پروجکشن توجه (q,k,v,o) و MLP (gate,up,down) — پیشفرض خوبی است.
- QLoRA: مدل پایه را ۴بیتی (NF4) بارگذاری میکند تا مدلهای بزرگتر در حافظهی کمتری جا شوند.
نکته: با ۰٫۵B و r=8 حدود ۴–۹ میلیون پارامتر قابلآموزش دارید — فایل Adapter نهایی چند ده مگابایت است.