دیتاست یک قول است
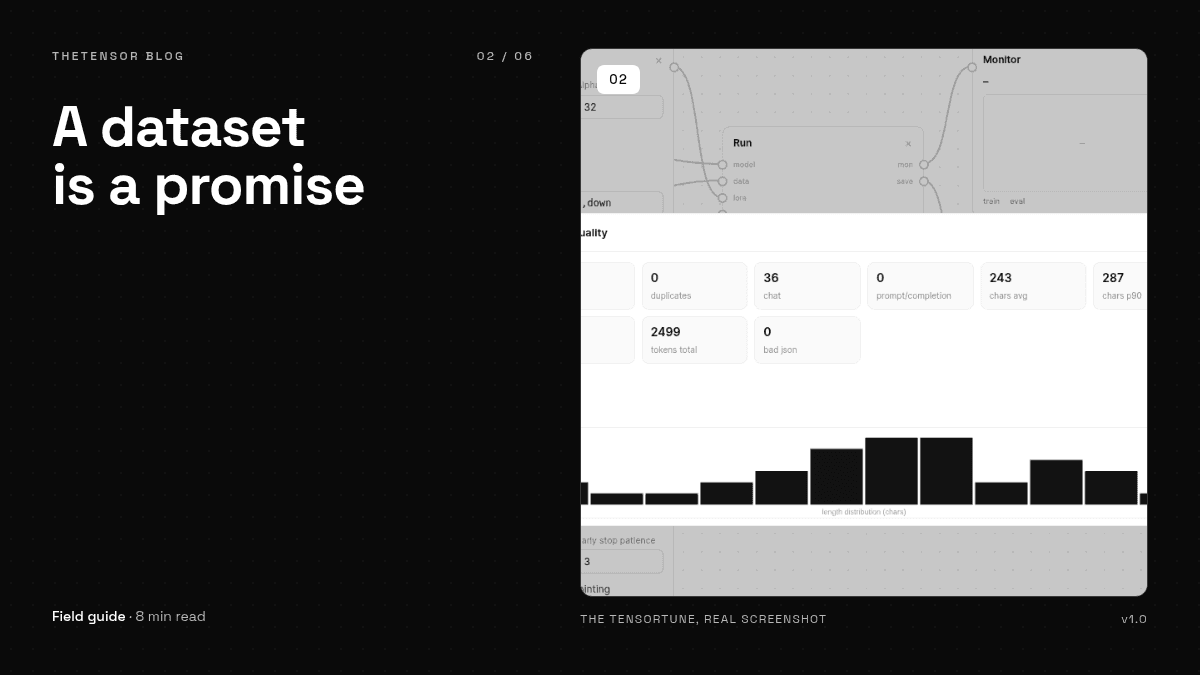
هرچه در دیتاست میگذارید، همان چیزی است که قول میدهید مدل بشود. فرمتها، اندازههای واقعبینانه، و خواندن گزارش کیفیت قبل از اینکه حتی یک epoch را روی داده خراب هدر بدهید.
فاینتیون هیچکس بهخاطر dropout اشتباه خراب نشده؛ بهخاطر دیتاستی که بیست نمونهی تقریباً یکسان و یک رمان چهلهزارکلمهای بود خراب شده. این نسخه کوتاه و نظردارِ چیزهایی است که موقع ساخت بلوک Dataset و گزارش کیفیتش یاد گرفتیم — بههمراه مدل ذهنی که همهچیز را سرجایش نگه میدارد: دیتاست یک قول است. هر نمونه به مدل میگوید «اینطور جواب بده». اگر نمونهها با هم یا با خواسته واقعی شما ناسازگار باشند، مدل با وفاداری کامل همان قول شکسته را نگه میدارد.
سه فرمت، سه نیت
- چت —
{"messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}]}. پیشفرض پیشنهادی. فقط نوبتهای دستیار آموزش میبینند، پس مدل جوابها را یاد میگیرد نه سوالها را. - پرامپت / پاسخ —
{"prompt":"...","completion":"..."}. برای کارهای تبدیلی: این متن را درست کن، این را دستهبندی کن، این مخفف را باز کن. - متن آزاد —
{"text":"..."}یا هر خط ساده. برای انتقال سبک روی نوشتههای خام. هیچ ساختاری تحمیل نمیشود؛ یکدستیاش کاملاً با شماست.
فرمت یک جزئیات فنی نیست — تعیین میکند چه نوع قولی میدهید. نمونه چت به مدل یاد میدهد چطور به یکی جواب بدهد. پرامپت/پاسخ یادش میدهد یک تبدیل مشخص انجام بدهد. متن آزاد یادش میدهد چهطور صدا بزند. اگر بیمحاسبتی در یک دیتاست قاطی شوند، به قولی تار میشوند که مدل نمیتواند نگه دارد — برای همین است که گزارش کیفیت، ترکیب فرمتها را قبل از آموزش نشان میدهد.
چقدر بزرگ؟ کوچکتر از فکرتان
اینترنت طوری القا میکند که هزاران نمونه لازم دارید. با LoRA این فقط درست نیست. بیست تا چند صد نمونهی خوبانتخابشده میتواند لحن و قالب را بهشکل چشمگیری جابهجا کند — تمام جذابیت روش همین است. دیتاست نمایشی ما ۳۶ نمونه چت از پشتیبان یک اپراتور اینترنت خیالی است و تا آخر آموزش، مدل هر پاسخ را با همان امضای پایانی میبست و با همان لحن کوتاه و مهربان جواب میداد. چیزی که مهم است حجم نیست. یکدستی: نمونههایی که درباره اینکه چه کسی حرف میزند توافق دارند. پوشش: موقعیتهایی که میخواهید مدیریت شوند. صداقت: پاسخهایی که نمایندهی چیزیاند که واقعاً میخواهید، نه چیزی که دوست داشتید بگویید.
خواندن گزارش کیفیت
دکمه بررسی کیفیت را بزنید تا گزارش، واقعیتها را بدهد؛ چهار تا از اینها اولین نگاه را میخواهند.
- موارد تکراری — سریعترین راه رسیدن به مدلی که یک چیز را، بینقص، همیشه میگوید. قبل از آموزش تکراریها را حذف کنید.
- هیستوگرام طول — نمونههای بلندتر از
maxlenبریده میشوند. اگر بیشتر دادهتان ته نمودار جمع شده، maxlen را بالا ببرید یا نمونهها را بشکنید. - ترکیب زبان — زبانهای تشخیصدادهشده، فارسی و ایموجی هم. یک زبان غیرمنتظره معمولاً یعنی خطای paste.
- ترکیب فرمت — چه چیزی چت خوانده شد، چه چیزی پرامپت/پاسخ، چه چیزی به متن آزاد برگشت. بازگشتهای بیصدا همانجاییاند که سورپرایزهای آموزش ازشان میآیند.
eval split: به خودتان قول نگه دارید
eval_pct را بین ۱۰ و ۲۰ بگذارید تا تمیزترین نمونهها تبدیل به مدرک شوند. صفحه مقایسه perplexity را روی دادهای میسنجد که مدل هرگز رویش آموزش ندیده — تنها راه صادقانه برای فهمیدن اینکه تنظیم نشسته یا نه. eval split صفر وسوسهکننده است — دیتاست بیشتر! — اما شما را به یک حس رها میکند. کل هدف این تمرین جایگزینی حسها با اعداد است و این ارزانترین عدد منوی امروز است.