از آداپتور تا Ollama: خروجی، از اول تا آخر
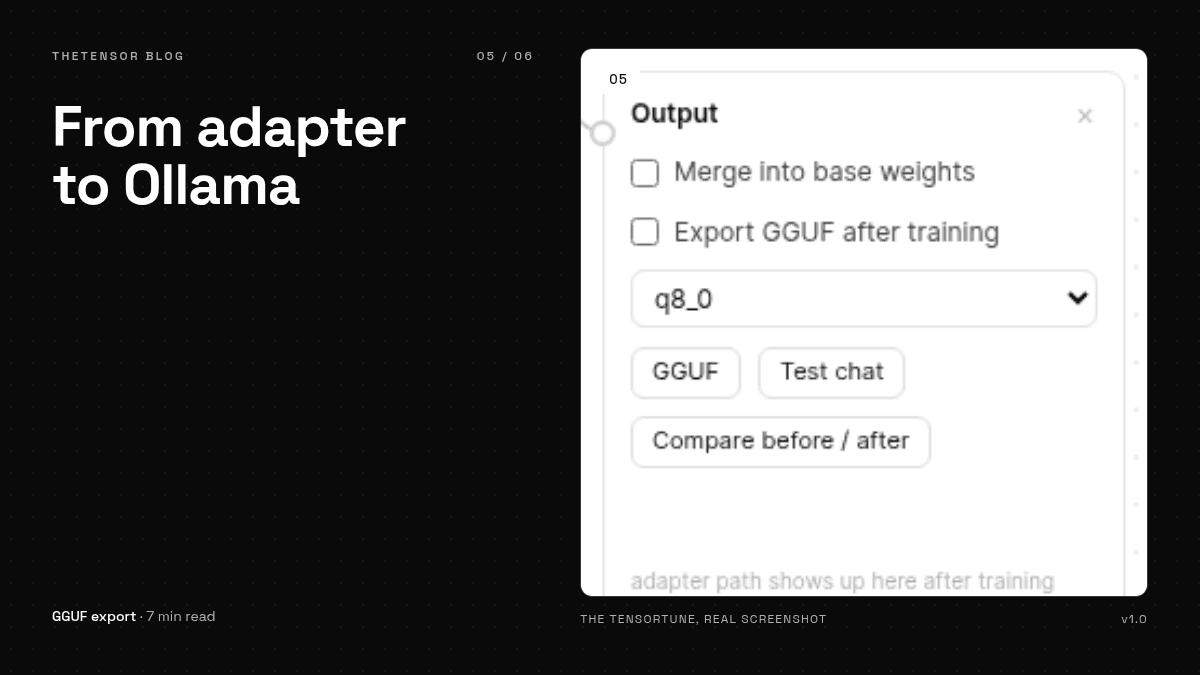
مرور مایل آخرِ فاینتیون: آداپتور چیست، ادغام چه میکند، کوانت را چطور انتخاب کنیم، و چطور فایل خروجی را در حدود یک دقیقه در Ollama اجرا کنیم.
آموزش همهی افتخارات را میگیرد، اما مایل آخر فاینتیون خروجی است — لحظهای که مدل تنظیمشدهتان از یک دایرکتوری از بقایای آموزش به یک فایل واحد تبدیل میشود که میشود دستِ ابزارهای دیگر کرد. این پست همان مایل را در TheTensorTune قدمبهقدم میرود: وقتی دکمه GGUF را میزنید واقعاً چه اتفاقی میافتد، کدام کوانت را برداریم، و چطور نتیجه را قبل از سرد شدن چای در Ollama اجرا کنیم.
بعد از آموزش در دستتان چیست
یک اجرای LoRA مدل پایه را تغییر نمیدهد. یک آداپتور مینویسد — فایل کوچکی از ماتریسهای کمرتب، معمولاً چند ده مگابایت، که چیزهایی که اجرا یاد گرفته را در خود دارد. مدل پایه همانطور که دانلودش کردید میماند و آداپتور فقط کنارش معنا دارد. برای همین است که برنامه حالت چت Merged دارد: آداپتور را روی وزنهای پایه در حافظه اعمال میکند تا با مدل ترکیبی حرف بزنید. و برای همین حالت Base هم دارد، تا «قبل» را بدون رنگ «بعد» بشنوید.
آداپتور بهعلاوه مدل پایه داخل برنامه کافی است، اما بقیه دنیا — Ollama، llama.cpp، LM Studio — تکفایل حرف میزنند. آن فایل GGUF است و ساختنش کار دونیمساعتی نیست: آداپتور را در وزنهای پایه ادغام کن، بعد نتیجه را کوانتیزه کن.
انتخاب کوانت
- f16 — کپی دقیق وزنهای ادغامشده، بزرگترین فایل. وقتی بردارید که حجم مسئله نیست و غیر از خود ادغام هیچ خطایی نمیخواهید.
- q8_0 — یک بایت به ازای هر وزن. خطای ناچیز، فایل خیلی کوچکتر. پیشفرض پیشنهادی همین است و خروجیهای نمایشی ما هم با همین ساخته میشوند.
- K-quantها (مثل q4_k_m) — تقریباً یکچهارم حجم f16، با هزینهی کوچکی از کیفیت. به llama-quantize نیاز دارند که برنامه از PATH یا با
TT_LLAMA_CPPپیدایش میکند.
یک راه عملی برای تصمیم: q8_0 را بردارید، باهاش چت کنید، و اگر جوابها هنوز همان چیزی بود که در برنامه دیدید، تمام است. فقط وقتی حجم فایل دستتان را بسته، سراغ کوانت کوچکتر بروید — و بعد دوباره تست کنید، چون کوانتیزهسازی مدلها را به روشهایی تغییر میدهد که پیشبینیشان خستهکننده و دیدنشان راحت است.
خودِ خروجی
روی بلوک Output کوانت را انتخاب کنید و GGUF را بزنید. پیشرفت به شکل یک toast نمایش داده میشود و وقتی تمام شود مسیر فایل و لینک دانلود را میگیرید. فایل کنار checkpoint همان اجرا مینشیند و اسمش از کوانت انتخابی میآید. خروجی توکنایزر، تنظیمات معماری و پیکربندی attention را حفظ میکند — همان بخش بیسروصدایی که تعیین میکند مدل خروجی مثل مدلی که تست کردید جواب بدهد یا نه. بیسروصداست، ولی ارزش چک کردن دارد: اولین کاری که با یک خروجی باید بکنید این است که همان پرامپت صفحه مقایسه را ازش بپرسید.
یک دقیقه تا Ollama
# کنار فایل خروجی
cat > Modelfile <<EOF
FROM ./model-q8_0.gguf
EOF
ollama create my-tuned -f ./Modelfile
ollama run my-tuned
کل مراسم همین است. Ollama فایل Modelfile را میخواند، مدل را با اسمی که دادید ثبت میکند و مثل بقیه مدلها سرو میکند. از اینجا به بعد مدل همانقدر قابل حمل است که یک فایل قابل حمل است: به یک سیستم دیگرش کپی کنید، روی یک شیر بگذاریدش، به یک دوست بدهید. آداپتور دیگر یک پروژه نیست؛ یک چیز است.
اگر نسخه بلند هر قدم اینجا را میخواهید، درس ۱۱ دوره داخلی صفحه خروجی را با جزئیات میگیرد و INSTALL.md هم مسیر APIای را مستند کرده که همین کار را از داخل اسکریپت انجام میدهد.