LoRA، به زبان آدمیزاد
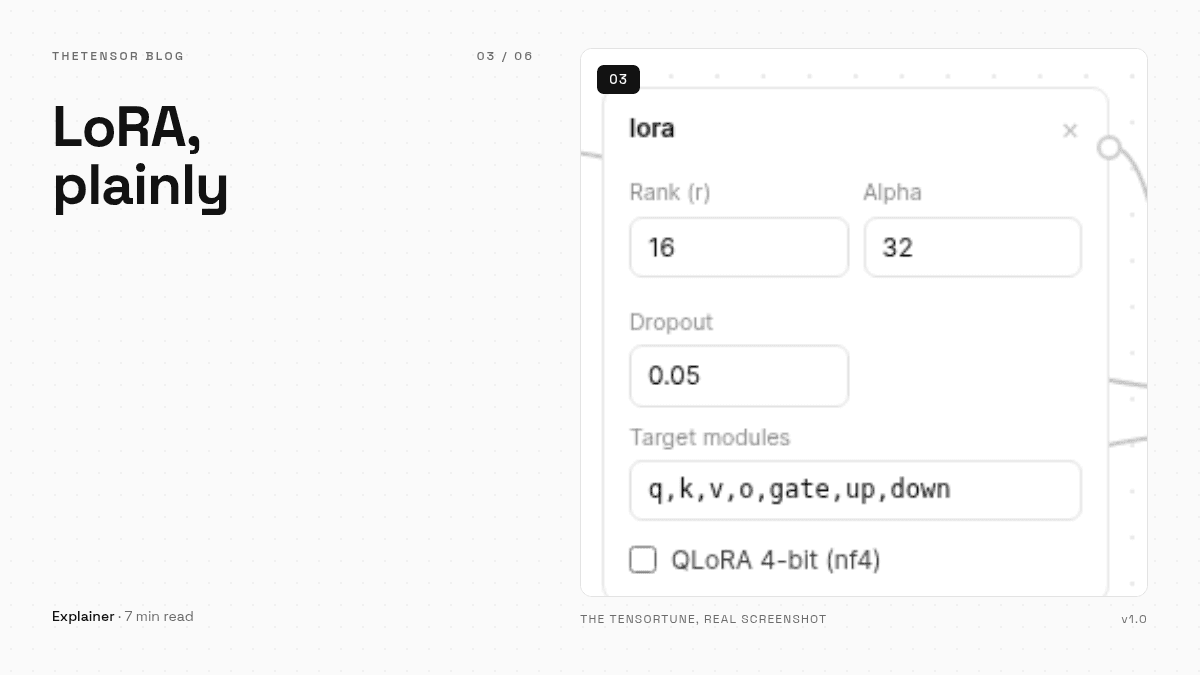
LoRA واقعاً چه میکند، بدون سردرد ریاضی: وزنهای پایه منجمد، یک روکش کوچک آموزشپذیر، و اینکه rank و alpha و dropout و لایههای هدف هرکدام چه چیزی را عوض میکنند — و کی ارزش QLoRA دادن دارد.
LoRA را معمولاً با ماتریس و تجزیه رتبه و کوهی از نماد ریاضی توضیح میدهند. اگر پیادهسازیکار باشید مفید است و اگر بخواهید همین بعدازظهر یک مدل فاینتیون کنید بیفایده. این نسخه کاربردی است؛ همان که کنار فیلدهای واقعی بلوک LoRA جا میشود.
ایده اصلی در یک پاراگراف
فاینتیون کامل، همهی وزنهای مدل را بازنویسی میکند — میلیاردها عدد، گیگابایتها گرادیان. LoRA شرط دیگری میبندد: وزنهای اصلی را کامل منجمد کن و کنارشان یک جفت ماتریس کوچک آموزش ببین که حاصلضربشان همان تغییری را تقریب بزند که میخواستی. مدل دستنخورده میماند. آموزش شما یک روکش نازک مینویسد و تنها چیزی که ذخیره میشود همین روکش است. برای همین یک اجرای LoRA کسری از حافظه میخواهد و نتیجهاش یک فایل آداپتور به اندازه چند ده مگابایت است، نه یک کپی کامل مدل.
رتبه: روکش چقدر میتواند حرف بزند
رتبه (r) عرض همان ماتریسهاست — تعداد جهتهای مستقلی که روکش میتواند ابراز کند. رتبه ۸ یک روکش جمعوجور برای تغییرات لحن، قالب و سبک میدهد. رتبه ۱۶ تا ۳۲ برای رفتار غنیتر جا باز میکند، به قیمت آداپتور بزرگتر و کمی حافظه بیشتر. روی یک مدل کوچک با r=16 تقریباً چند میلیون پارامتر آموزش میبینید — حدود یک درصد مدل. همین نسبت تمام ترفند است: روکش کوچک، مدل پایه دستنخورده.
آلفا: بلند حرف میزند
alpha مقیاس آن است که سهم روکش چقدر محکم با خروجی مدل مخلوط شود. قرارداد جامعه این است که alpha = 2 × r؛ برای همین جفتهای ۸/۱۶ و ۱۶/۳۲ همهجا دیده میشوند، از جمله در ما. نکتهی لایق دانستن: چیزی که مهم است نسبت alpha / r است، نه هیچکدام بهتنهایی. نسبت را حدود دو نگه دارید تا گران نباشید. روزی که خواستید آزمایش کنید، همان ولومی است که دستتان میگیرد.
dropout و لایههای هدف
dropout (مقدار ۰.۰۵ انتخاب خوبی است) موقع آموزش بهطور تصادفی بخشی از روکش را ساکت میکند تا نتواند دیتاست را کلمهبهکلمه حفظ کند. بیشترین اثرش روی دیتاستهای کوچک است — که واقعبینانه بگوییم، بیشتر دیتاستهای فاینتیون همینها هستند.
لایههای هدف تعیین میکنند روکش کجا وصل شود. مجموعه پیشفرض، تصاویر attention (q، k، v، o) بهعلاوه بلوک MLP (gate، up، down) را میپوشاند — دستور کار استاندارد و همان چیزی که TheTensorTune باهاش میآید. مجموعه باریکتر سریعتر آموزش میبیند ولی کمتر یاد میگیرد؛ پیشفرض انتخاب خستهکننده و قابلاعتماد است و «خستهکننده» در این حوزه تعریف است.
QLoRA: همان ایده، جعبه کوچکتر
QLoRA همهی بالا را نگه میدارد اما مدل پایه منجمد را به جای دقت کامل، ۴بیتی (NF4) بارگذاری میکند تا مدلی که حافظه زیادی میخواست در کسری از آن جا شود. همان روکش را آموزش میبینید؛ فقط پایه حین کار جای کمتری میگیرد. در بلوک LoRA به شکل یک سوییچ عرضه میشود نه پیشفرض، چون روی مدلهای کوچک این فشردهسازی کمتر از هزینهاش میارزد. روشنش کنید وقتی مدلی که میخواهید از فضایی که دارید بزرگتر است.
این LoRA بود بدون حتی یک ماتریس: یک عدد رتبه، یک ولوم، کمی dropout و مجموعهای معقول از لایهها. r را ست کنید، آلفا را دوبرابرش، و باقی حواستان را بدهید به دیتاست — چون فاینتیون همانجا برنده میشود.