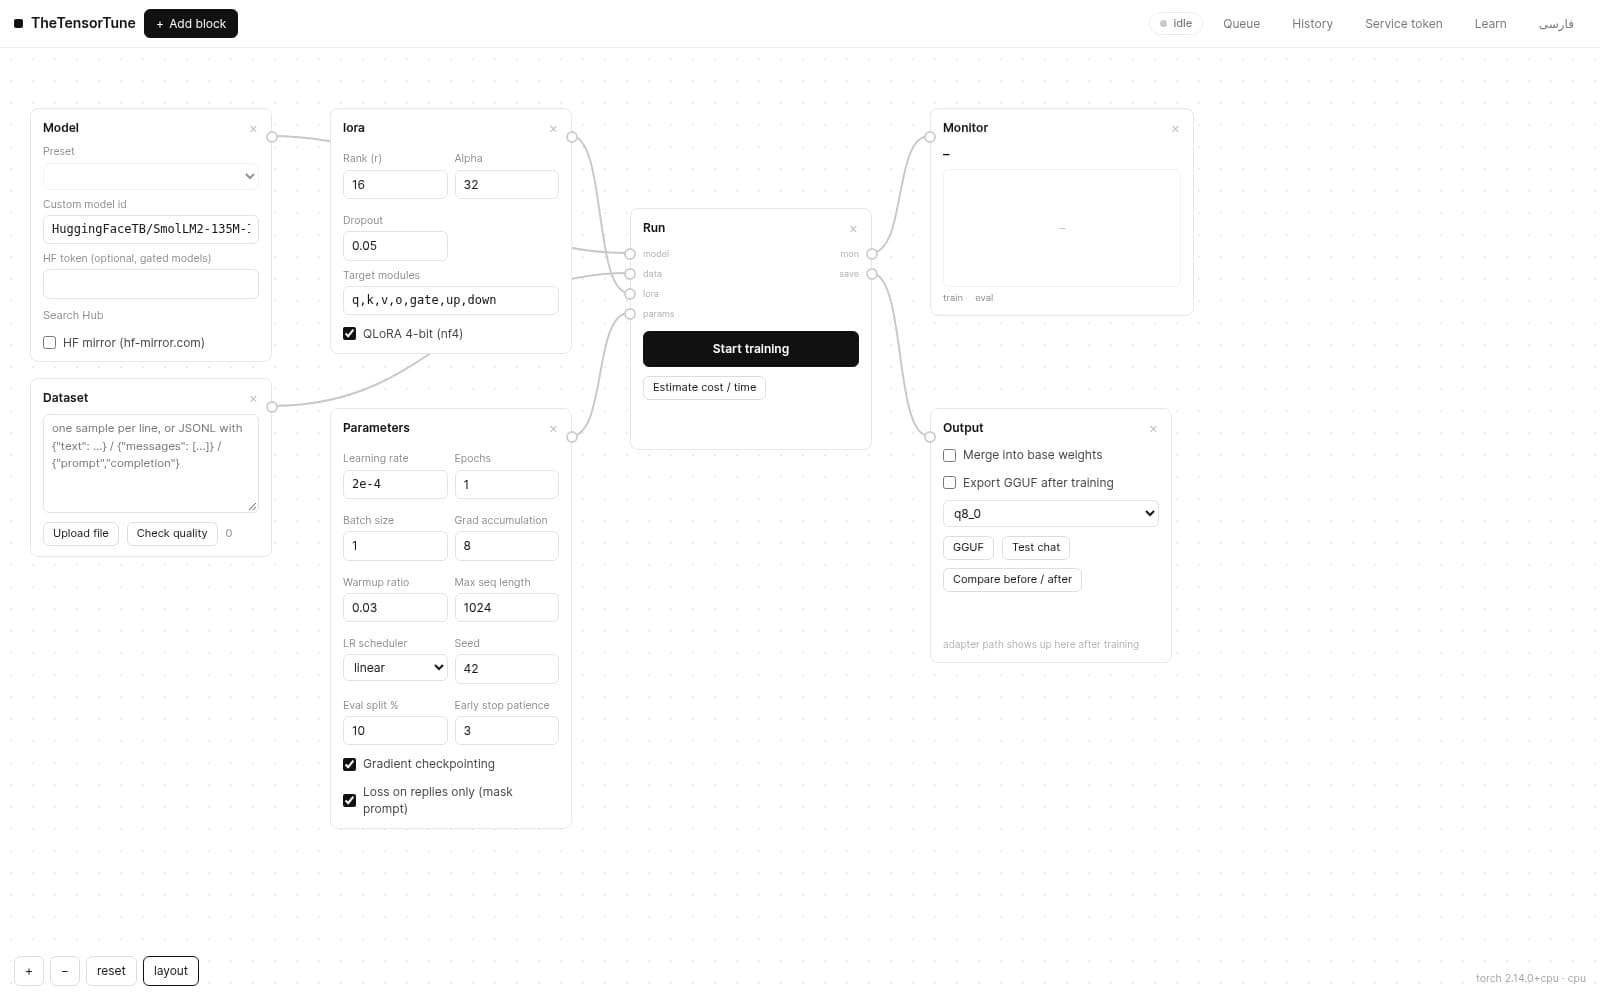
出力ブロック(またはHistoryのラン行)のGGUFボタンがモデルをマージし、runの横に.ggufファイルを書き出します — llama.cpp / Ollama / LM Studioでそのまま使えます:
- quant:
f16(正確、大容量)、q8_0(低誤差・コンパクト — 推奨)、q4_k_m等のK-quant(PATH上のllama-quantizeまたはTT_LLAMA_CPPが必要)。 - エクスポートの進捗はモーダルに表示。完了するとファイルパスとダウンロードが提供されます。
- メタデータは intact:トークナイザ、アーキテクチャ、attentionバイアスが保持され、エクスポート済みモデルの応答は元モデルと一致します。
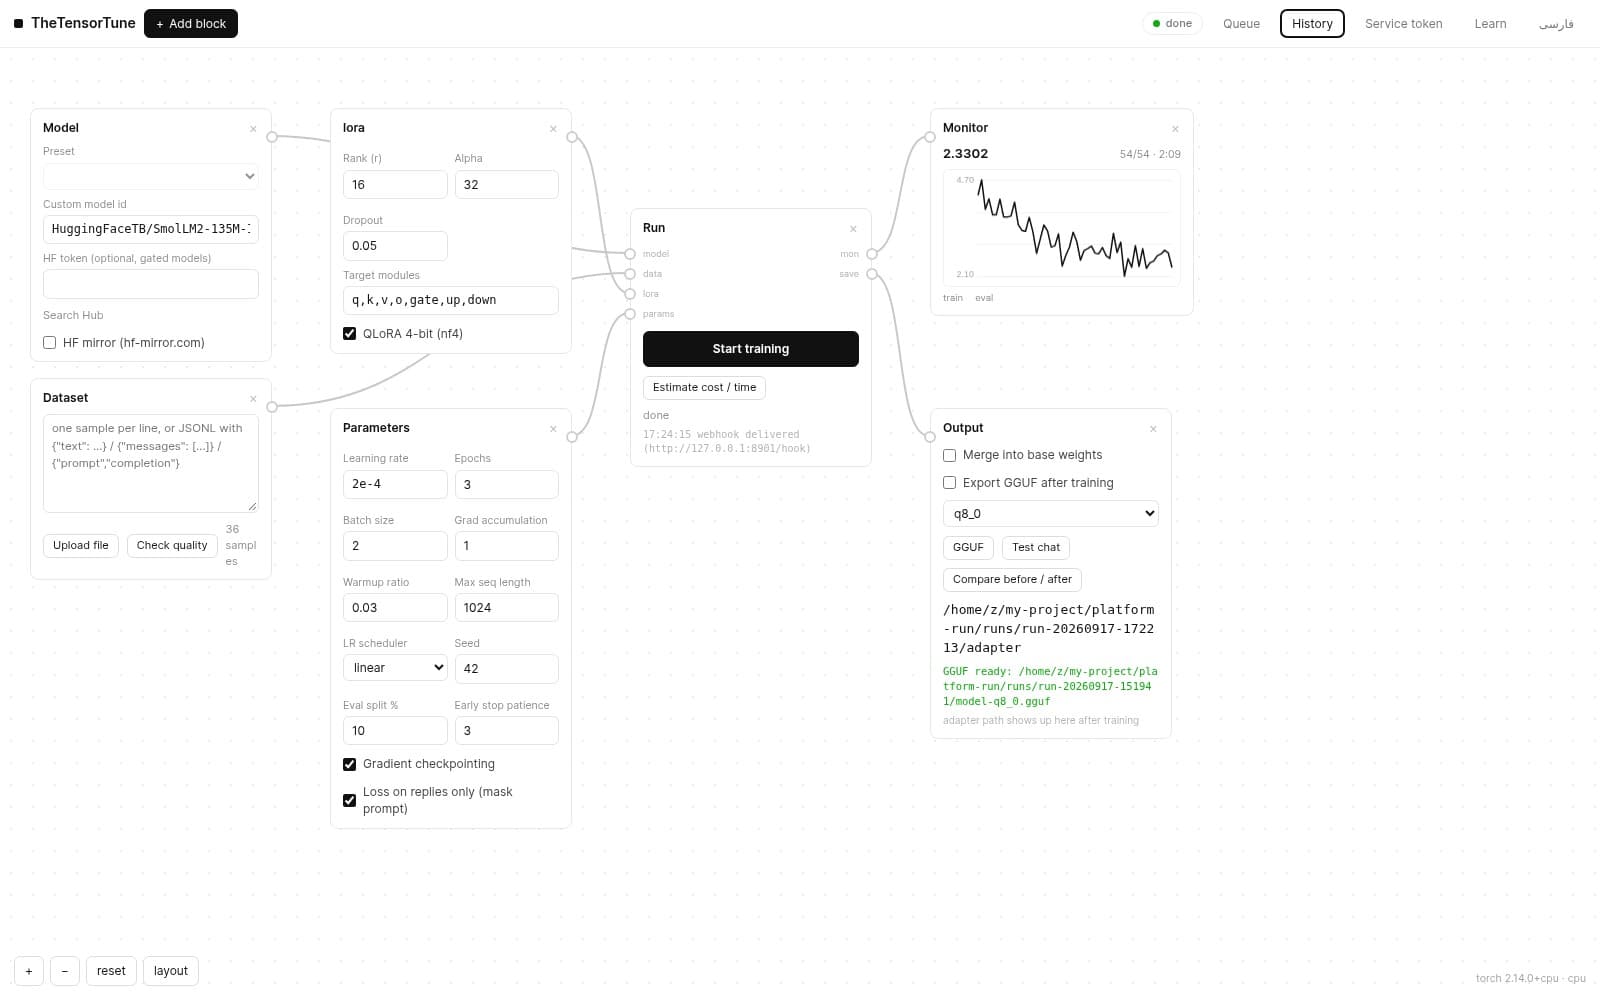
ヒント:q8_0のエクスポートは元モデルと同じ応答を返します — トークナイザー、アーキテクチャ、attention設定がすべて保持されます。