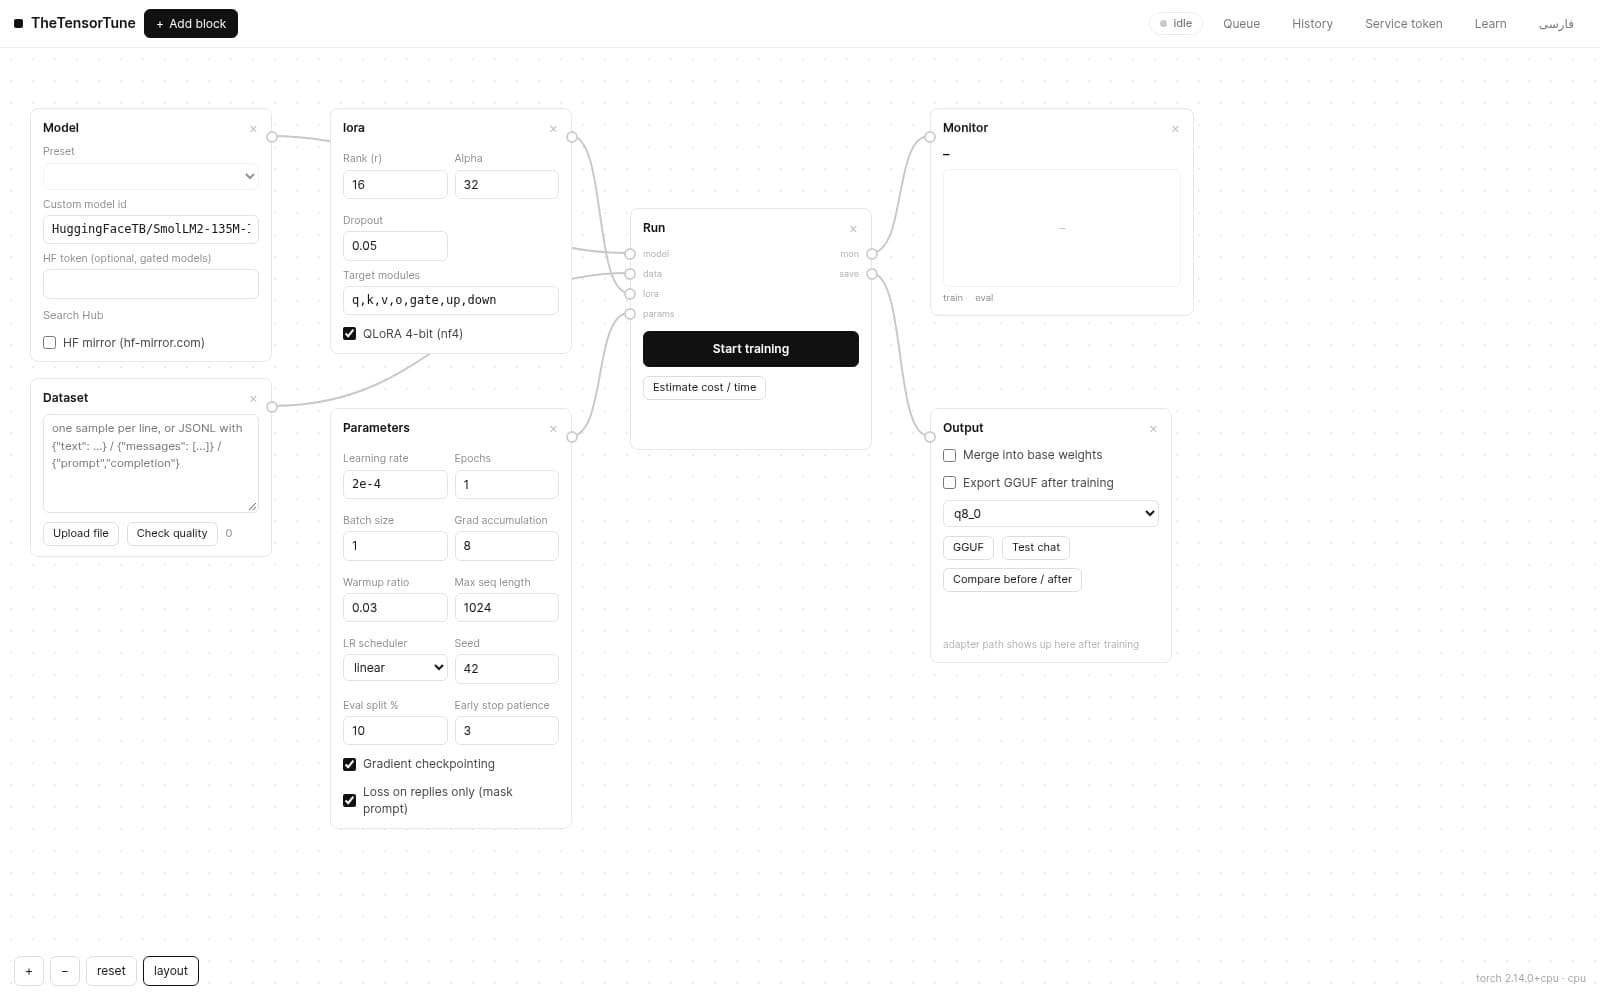
LoRAブロックは、モデルのどの部分がどの容量で学習するかを決めます。ベースの重みは凍結されたまま、低ランク行列だけが学習します — だからメモリもディスクも少なくて済みます。
- rank (r):学習容量。軽いスタイル課題は8、豊かな振る舞いには16〜32。rが大きいほどアダプターも大きく。
- alpha:LoRAパスの出力スケール。慣習は
alpha = 2×r。 - dropout:0.05が定番。小さいデータセットで効きます。
- targets:注意プロジェクション(q,k,v,o)とMLP(gate,up,down) — 堅実なデフォルト。
- QLoRA:ベースモデルを4bit(NF4)で読み込み、大きいモデルをより少ないメモリで扱えるようにします。
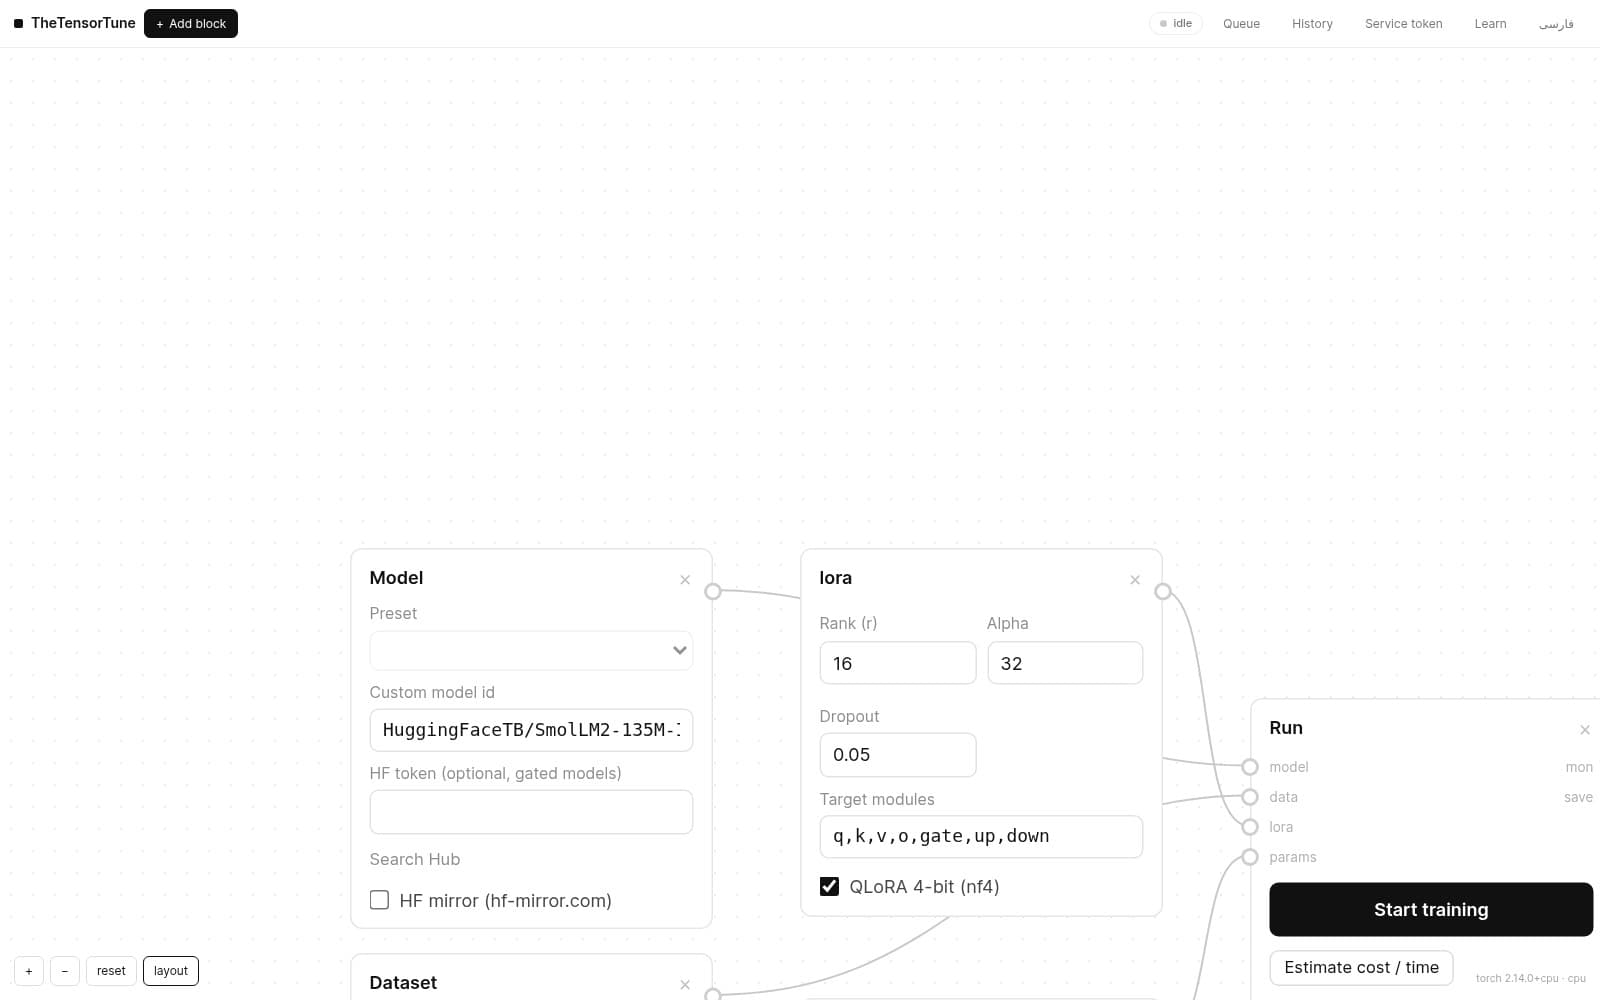
ヒント:0.5Bモデルでr=8なら学習パラメータは約400〜900万 — 最終的なアダプターファイルは数十メガバイトです。