データセットは約束だ
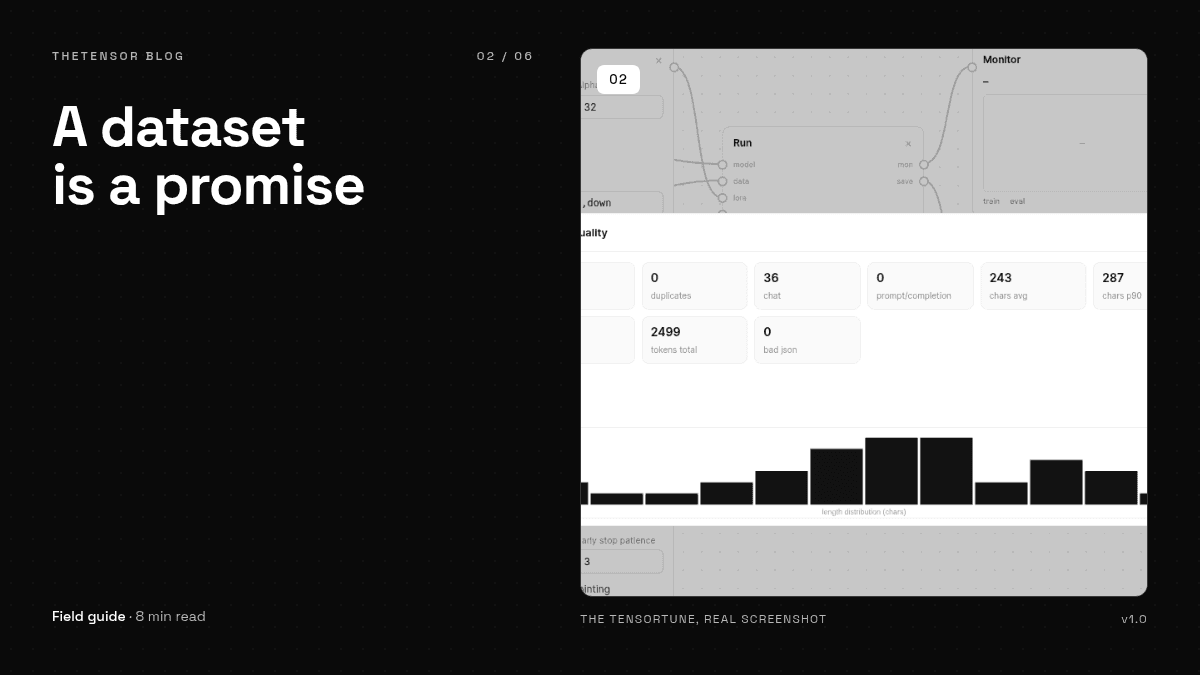
データセットに入れるものは、モデルがそうなると約束するものそのものです。形式、現実的なサイズ、そして悪いデータに1エポックも無駄にする前に品質レポートを読む方法。
dropout の選択を間違えてファインチューニングが失敗した人はいません。ほぼ同一のサンプル20個と4万字の小説1つで構成されたデータセットで失敗した人は大勢います。これは、Dataset ブロックと品質レポートを作りながら学んだことの短くて毒のある要約です。そしてすべてを座標に置く頭のモデルはこうです。データセットは約束です。各サンプルはモデルに「こう答えろ」と告げています。サンプル同士が、あるいはあなたの本当の望みと矛盾するなら、モデルはその壊れた約束を忠実に守ります。
3つの形式、3つの意図
- チャット —
{"messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}]}。推奨の初期値。学習されるのは応答側だけで、モデルは質問ではなく答えを学びます。 - プロンプト / 応答 —
{"prompt":"...","completion":"..."}。変換タスク向き。このテキストを直せ、これを分類しろ、この略語を展開せよ。 - フリーテキスト —
{"text":"..."}または任意の行。生の文章へのスタイル転写向き。構造は課されず、一貫性は完全にあなたの仕事です。
形式は技術的な小さな話ではありません。どんな約束をするかを決めます。チャットのサンプルは「誰かに応答する方法」を教え、プロンプト/応答は「特定の変換を行う方法」を教え、フリーテキストは「どう聞こえるか」を教えます。注意なく1つのデータセットに混ぜれば、モデルには守れない約束に滲み、だから品質レポートは学習前に形式の内訳を見せます。
どれくらいの大きさ? 思っているより小さい
インターネットは何千サンプルが必要だとほのめかします。LoRA ではそれは単に正しくありません。よく選ばれた20〜数百サンプルで、トーンと形式は劇的に動きます。それがこの手法の魅力のすべてです。私たちのデモデータセットは架空のISPのサポート担当者のチャット36サンプルで、学習が終わる頃にはモデルはすべての応答に同じ署名を付け、同じ簡潔で親切な口調で答えていました。重要なのは量ではありません。一貫性(誰が話しているかでサンプルが一致していること)。網羅性(扱いたい状況を押さえていること)。正直さ(欲しい答えではなく、実際の答えに即した応答であること)。
品質レポートを読む
品質チェックを押せば、レポートが事実をくれます。最初に見るべきは4つ。
- 重複 — 「1つのことを完璧に、常に」言うモデルへの最短ルート。学習前に重複を除く。
- 長さのヒストグラム —
maxlenを超えるサンプルは切り詰められます。データがグラフの右端に生きているなら、maxlen を上げるかサンプルを分割。 - 言語の内訳 — 検出された言語(ペルシャ語と絵文字含む)。予期しない言語は、たいてい貼り付けミス。
- 形式の内訳 — 何がチャットに、何がプロンプト/応答に、何がフリーテキストに落ちたか。無音のフォールバックは学習の驚きの供給源。
eval スプリット:自分への約束を守る
eval_pct を10〜20にすれば、一番きれいなサンプルが証拠になります。比較画面は、モデルが一度も学習していないデータでパープレキシティを測ります。調整が効いたかを知る唯一の正直な方法です。ゼロ(データが増える!)は誘惑的ですが、感覚を信じるしかなくなります。この訓練の目的は感覚を数値で置き換えることで、これはメニューで一番安い数値です。