アダプタから Ollama まで:書き出しの全体像
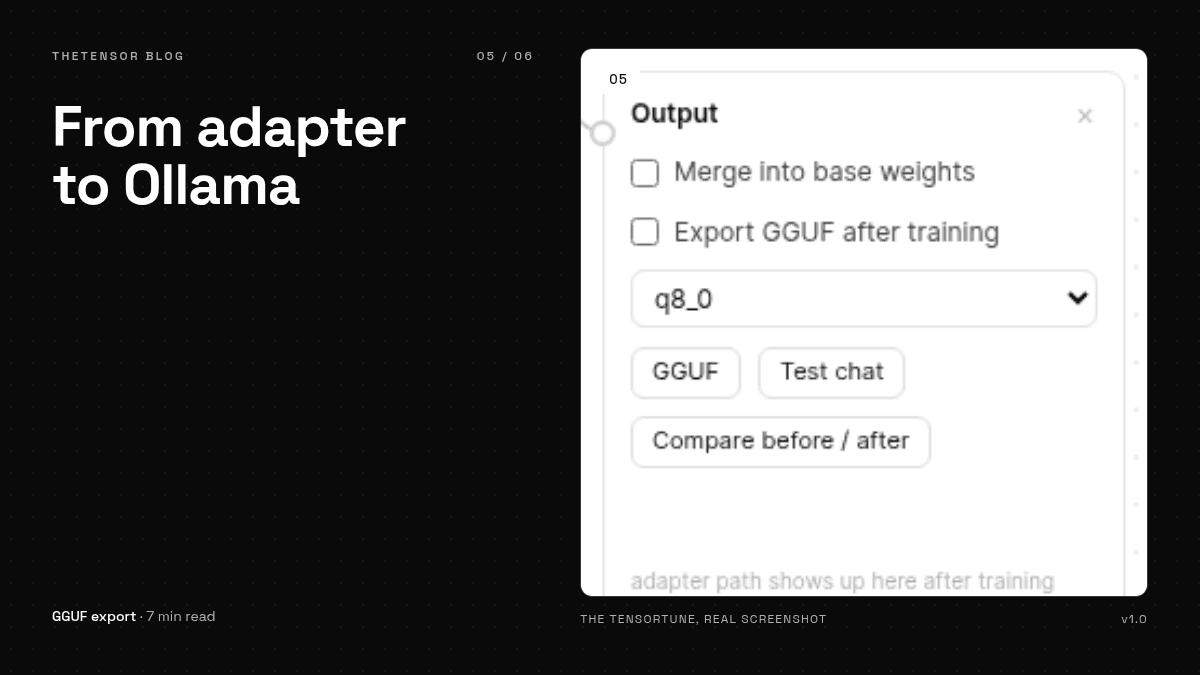
ファインチューニングの最後の1マイル。アダプタとは何か、マージは何をするか、量子化の選び方、そして書き出したファイルを1分ほどで Ollama で動かす方法。
華やかなのは学習のほうですが、ファインチューニングの最後の1マイルは書き出しです。学習済みモデルが学習の残骸のディレクトリではなくなり、他のツールに手渡せる単一ファイルになる瞬間。この投稿では TheTensorTune でその1マイルを歩きます。GGUF を押したとき実際に何が起きるか、どの量子化を選ぶか、そしてお茶が冷める前に結果を Ollama で動かす方法。
学習後に手元にあるもの
LoRA の実行はベースモデルを変更しません。代わりにアダプタを書き出します。通常数十メガバイトの低ランク行列の小さなファイルで、実行が学んだ内容を保持します。ベースモデルはダウンロードしたときのまま、アダプタはそれと並んで初めて意味を持ちます。だからチャットに Merged モードがあります。メモリ上でベースの重みにアダプタを適用し、統合されたモデルと会話できるようにするためです。そして Base モードがあるから、「後」の色に染まらずに「前」を聞けます。
アダプタ+ベースモデルはアプリの中では十分ですが、外の世界(Ollama、llama.cpp、LM Studio)は単一ファイルで話します。そのファイルが GGUF で、作り方は2ステップ。アダプタをベースの重みにマージし、結果を量子化する。
量子化の選択
- f16 — マージ済み重みの正確なコピー。最大のファイル。サイズが問題にならず、マージ以上の劣化を望まないときに。
- q8_0 — 重み1つあたり1バイト。誤差はわずかで、ファイルはかなり小さい。推奨の初期値で、私たちのデモ書き出しもこれです。
- K-quant(q4_k_m など) — f16 の約4分の1のサイズで、品質の代償は小さい。llama-quantize が必要で、アプリは PATH または
TT_LLAMA_CPPから探します。
実用的な決め方:q8_0 で書き出して会話し、アプリで見た応答とまだ一致していれば完了です。ファイルサイズに迫られたときだけ、より小さい量子化に下げる。そして必ず再テスト。量子化は予測が退屈で、気づくのが簡単な形でモデルを変えます。
書き出し本体
出力ブロックで量子化を選び、GGUF を押します。進捗はトーストに表示され、完了するとファイルパスとダウンロードリンクを得ます。ファイルは実行のチェックポイントの隣に、選んだ量子化の名前で置かれます。書き出しはトークナイザ、アーキテクチャ設定、attention 構成を保存します。地味ですが、この部分が「書き出したモデルが検証した通りに応答するか」を決めます。地味で、確認する価値あり。書き出したら最初に、比較画面と同じプロンプトを投げてみてください。
Ollama まで1分
# 書き出したファイルの隣で
cat > Modelfile <<EOF
FROM ./model-q8_0.gguf
EOF
ollama create my-tuned -f ./Modelfile
ollama run my-tuned
儀式はこれで全部です。Ollama が Modelfile を読み、指定した名前でモデルを登録し、他と同じように扱います。ここから先、モデルは単一のファイルが可搬であるのと同じだけ可搬です。別のマシンにコピーし、共有に置き、友達に渡せます。アダプタはプロジェクトであることをやめ、1つの「モノ」になりました。
各ステップの長い版が必要なら、内蔵コースのレッスン11が書き出し画面を詳しく扱い、INSTALL.md がスクリプトから同じ仕事をする API ルートを文書化しています。