LoRA を、わかる言葉で
LoRA が実際に何をするのか、数式の頭痛なしに。凍結されたベース重み、薄い学習可能なオーバーレイ、そして rank・alpha・dropout・対象レイヤーがそれぞれ何を変えるか。QLoRA が効くときも。
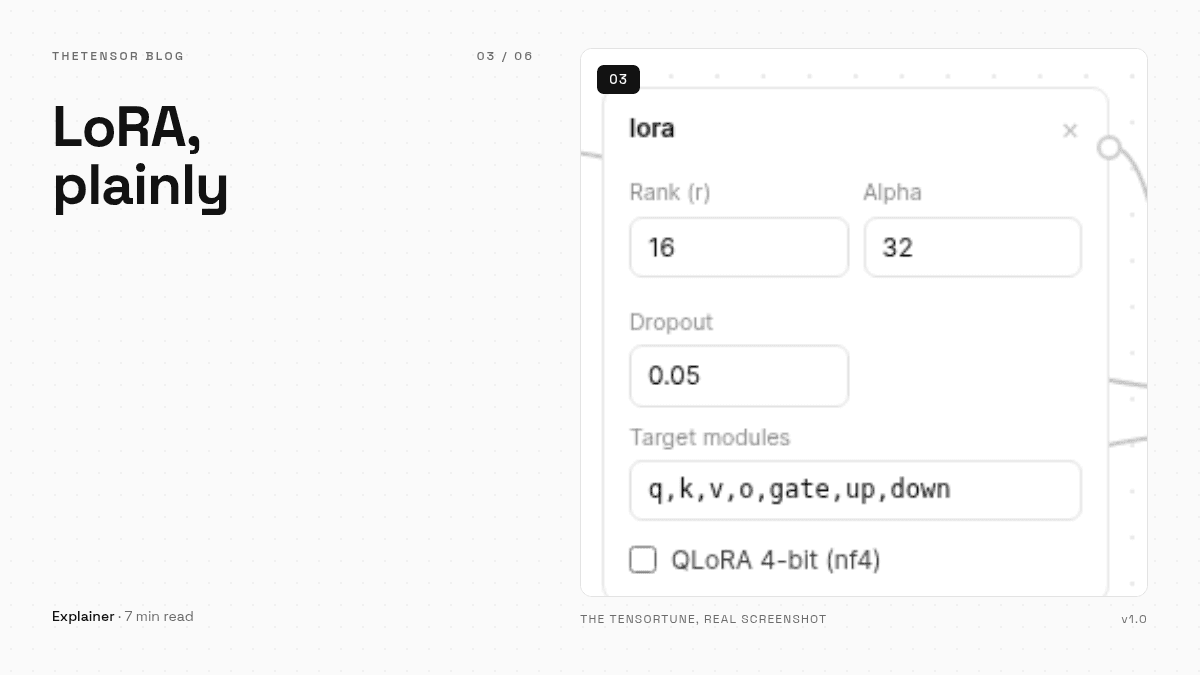
LoRA の説明には行列、ランク分解、記号の山が付きものです。実装するなら有用ですが、今日の午後にモデルをファインチューニングしたいだけなら無用です。こちらは実用版。LoRA ブロックの実際のフィールドの隣に収まるやつです。
核となる考えを1段落で
フルファインチューニングはモデルのすべての重みを書き換えます。数十億の数値、数ギガバイトの勾配。LoRA は別の賭けに出ます。元の重みを完全に凍結し、その隣に小さな行列のペアを学習させます。その積が、あなたが望んだ変化を近似します。モデルは無傷のまま。学習は薄いオーバーレイを書き、保存されるのはそのオーバーレイだけ。だから LoRA の実行に必要なメモリはほんの一部で、結果はモデル全体のコピーではなく数十メガバイトのアダプタファイルになります。
ランク:オーバーレイが言える量
ランク (r) はその行列の幅で、オーバーレイが表現できる独立した方向の数です。ランク8はトーン、形式、スタイルの変化に適したコンパクトなオーバーレイを与えます。ランク16〜32はより豊かな振る舞いの余地を買いますが、アダプタは大きくなり、メモリも少し増えます。小さいモデルで r=16 なら、学習されるのはおおよそ数百万パラメータ。モデルの約1パーセントです。この比率こそトリックの全体です。小さなオーバーレイ、無傷のベース。
アルファ:声の大きさ
アルファは、オーバーレイの寄与がモデルの出力にどれだけ強く混ざるかの倍率です。コミュニティの慣習は alpha = 2 × r。だから 8/16 と 16/32 の組がどこにでもあり、私たちもそうです。知っておくべき微妙な点は、どちらかの数値ではなく alpha / r の比が効くこと。比を2前後に保てば大きく外れません。実験したくなった日、回すのはこのダイヤルです。
ドロップアウトと対象レイヤー
ドロップアウト(0.05 で十分)は学習中にオーバーレイの一部をランダムに黙らせ、データセットを単語ごとに暗記できないようにします。小さなデータセットで最も効きます。現実的に言って、ファインチューニングに使われるデータセットの大半は小さいのですが。
対象レイヤーはオーバーレイをどこに差すかを決めます。デフォルトのセットは attention 射影(q, k, v, o)と MLP ブロック(gate, up, down)をカバーし、これが標準的なレシピで TheTensorTune の出荷時設定です。狭いセットは速く学習しますが学ぶ量は減ります。デフォルトは退屈で確実な選択で、この分野では「退屈」は褒め言葉です。
QLoRA:同じ考え、小さい箱
QLoRA は上記すべてを保ったまま、凍結されたベースを全精度ではなく4ビット (NF4) で読み込みます。多くのメモリを必要としたモデルが、その数分の1に収まります。学習するオーバーレイは同じ。ベースが作業中に占める場所が小さくなるだけです。デフォルトではなく LoRA ブロックのトグルとして提供しています。小さいモデルでは、この圧縮は費用に見合いません。欲しいモデルが持っているメモリより大きいときにオンに。
行列を1つも使わない LoRA の説明は以上です。ランクの数値、音量のつまみ、少しのドロップアウト、常識的なレイヤーのセット。r を決め、alpha は2倍にして、残りの注意力はデータセットに注ぎ込む。ファインチューニングはそこで勝ちます。