TheTensorTune を作った理由
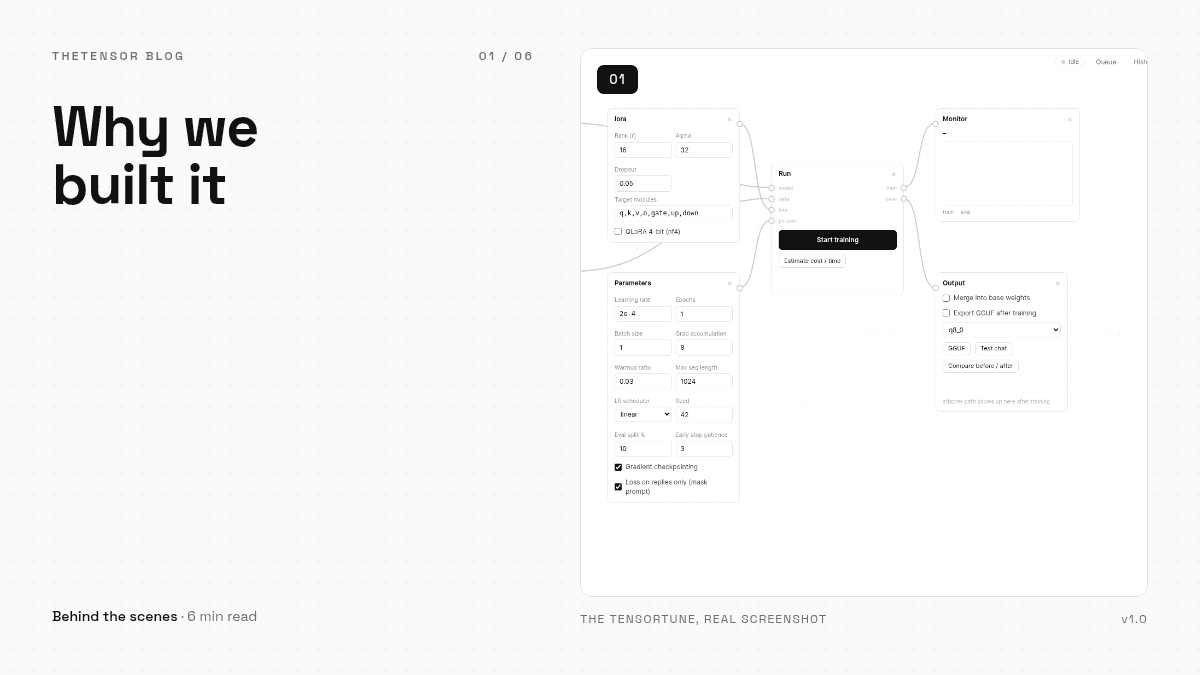
TheTensorTune の裏側の正直な話。既存のファインチューニングツールの何が困っていたのか、なぜすべてが1つの Python ファイルに収まらなければならなかったのか、v1.0 に何が入ったのか。
ファインチューニングのチュートリアルはどれも同じ始まり方をします。このリポジトリをクローンして、この14個をインストールして、この yaml をコピーして、バージョン衝突を直して、あと3つファイルを編集して、それで何も壊れていなければ、プログレスバーが1本手に入る。自分のデータに何が起きているのかは分からないまま。私たちはそのチュートリアルを数えきれないほど追いました。5つ目くらいの壊れた環境のあたりで、TheTensorTune のアイデアは冗談であることをやめました。
目的は、大手の学習フレームワークと競うことではありません。彼らは彼らの仕事が上手です。目的は、標準的なループ(データセット、モデル、LoRA設定、学習、評価、書き出し)を、ブラウザのタブから出ることなく、最初から最後まで見えて触れるものにすることでした。ファインチューニングはもう珍しい儀式ではありません。多くの人にとって日常の作業であって、チェックリストではなく作業台に値します。
1つのファイル、これは意図
この制約を書き出したとき、馬鹿げて聞こえました。アプリケーション全体が単一の Python ファイル。パッケージ構造も、ビルドステップも、コンテナイメージもなし。理由は実用的です。単一ファイルは読みやすく、監査しやすく、USBメモリに入れて同僚に渡せます。「これ、実際うちのデータに何をするの?」と聞かれたら、「ファイルを開いて見て」と答えられ、その答えは1晩の読書に収まります。
この制約はスコープに対しても私たちを正直にさせました。すべての機能はファイルの中の居場所を勝ち取る必要がありました。マイクロサービスやデータベースサーバーが必要なものは除外。生き残ったのが、今日見えるループです。配線されたブロックのキャンバス、データセット品質チェック、ライブグラフ付きの学習、チェックポイント付きのキュー、テストチャット、前後比較、GGUF エクスポート。それぞれが、ファインチューニング中に人が実際に持つ疑問に対応しています。
1.0 に何が入ったか
- 作業台 — 各段階がブロックになったノードグラフのキャンバス。英語と完全な右から左ペルシャ語。
- 本物の学習 — 中身は PEFT。チェックポイント、再開、早期終了つき。
- 成果物ではなく答え — テストチャットと並列比較。話しかけられないモデルはファイルであって、結果ではないから。
- 動く書き出し — ワンクリックでマージして GGUF に量子化。Ollama と llama.cpp にそのまま。
- アプリ内コース — 最初のアップロードから API 自動化まで、スクリーンショット付き12レッスン。
タグ 1.0 を打つ前に、リリースは50のテストシナリオ(機能30、エンドツーエンド20)と、パストラバーサル、SSRF、XSS、CSRF、トークン扱い、アップロード強化をカバーするセキュリティ回帰スイートを通りました。楽しくはなかったし、決して省略もしませんでした。あなたのファイルに触れ、ローカルサーバーを立てるツールは、まさにその箇所で退屈でなければなりません。
すでにモデルをファインチューニングしているなら、この作業台は「足りなかった近道」に感じられるはずです。やったことがないなら、レッスン1がゼロから始めて、一歩ずつ進めてくれます。どちらでも、壊れたら教えてください。リンクはフッターにあります。