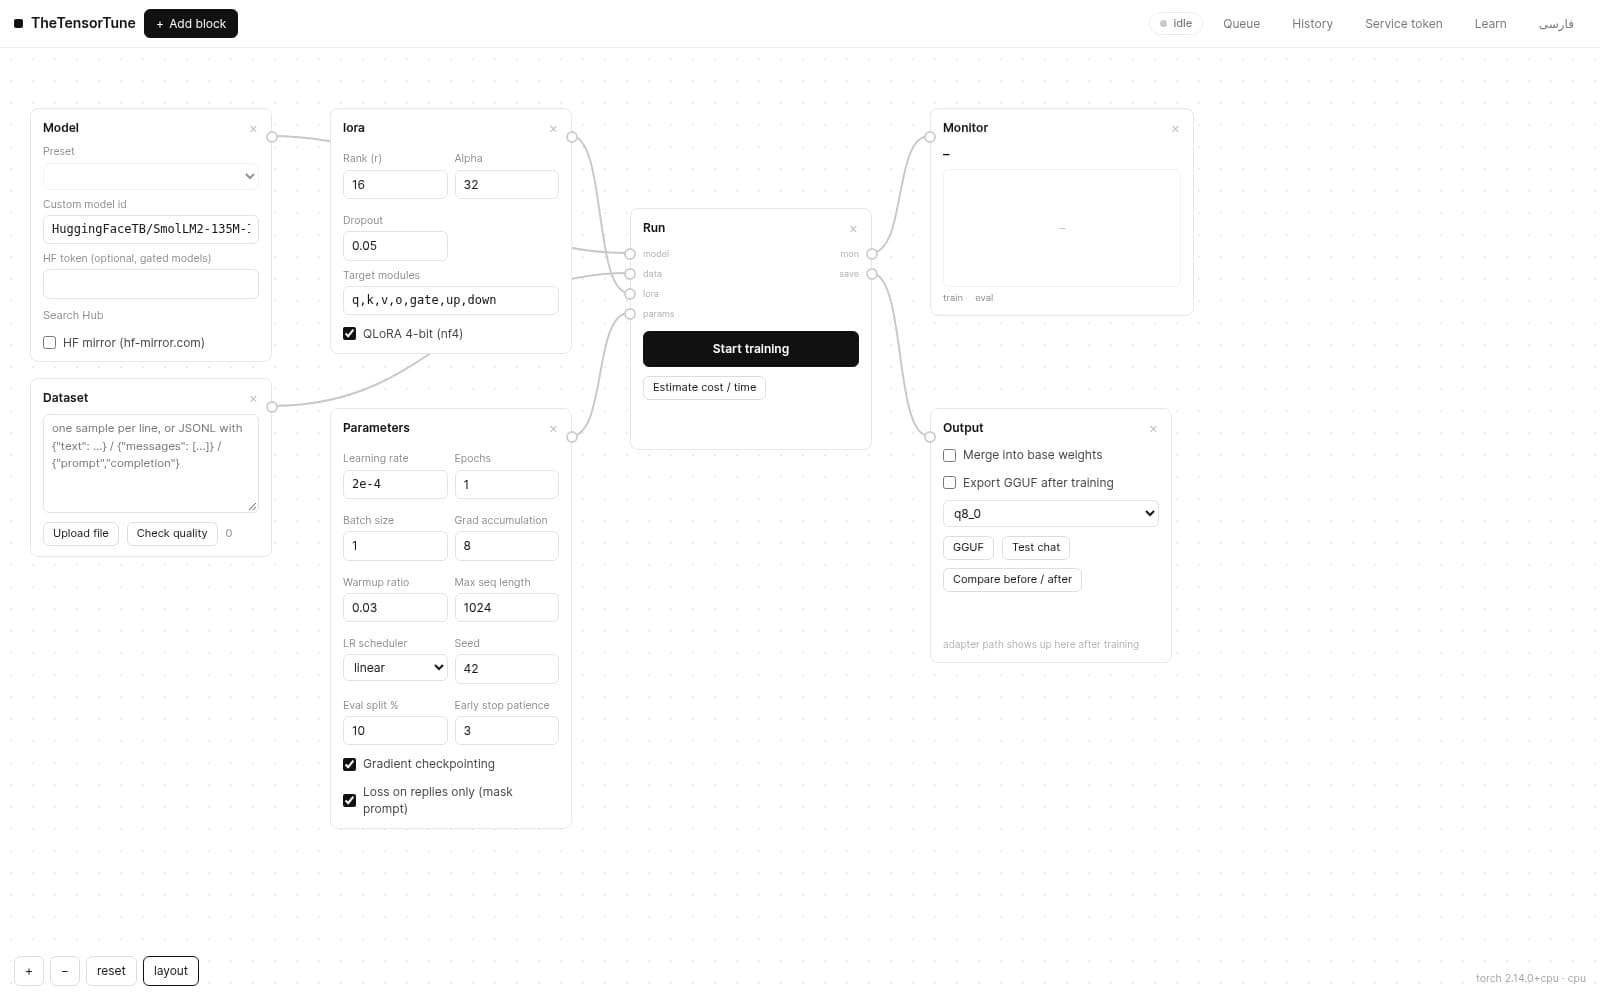
Кнопка GGUF на блоке вывода (или в строке запуска) сливает модель и пишет файл .gguf рядом с запуском — готово для llama.cpp / Ollama / LM Studio:
- quant:
f16(точно, большой),q8_0(низкая ошибка, компактно — рекомендуется) и K-кванты вродеq4_k_m(нужен llama-quantize в PATH или через TT_LLAMA_CPP). - прогресс экспорта виден в модалке; по завершении — путь к файлу и загрузка.
- метаданные сохраняются: токенизатор, архитектура и attention-биасы — ответы экспортированной модели совпадают с исходной.
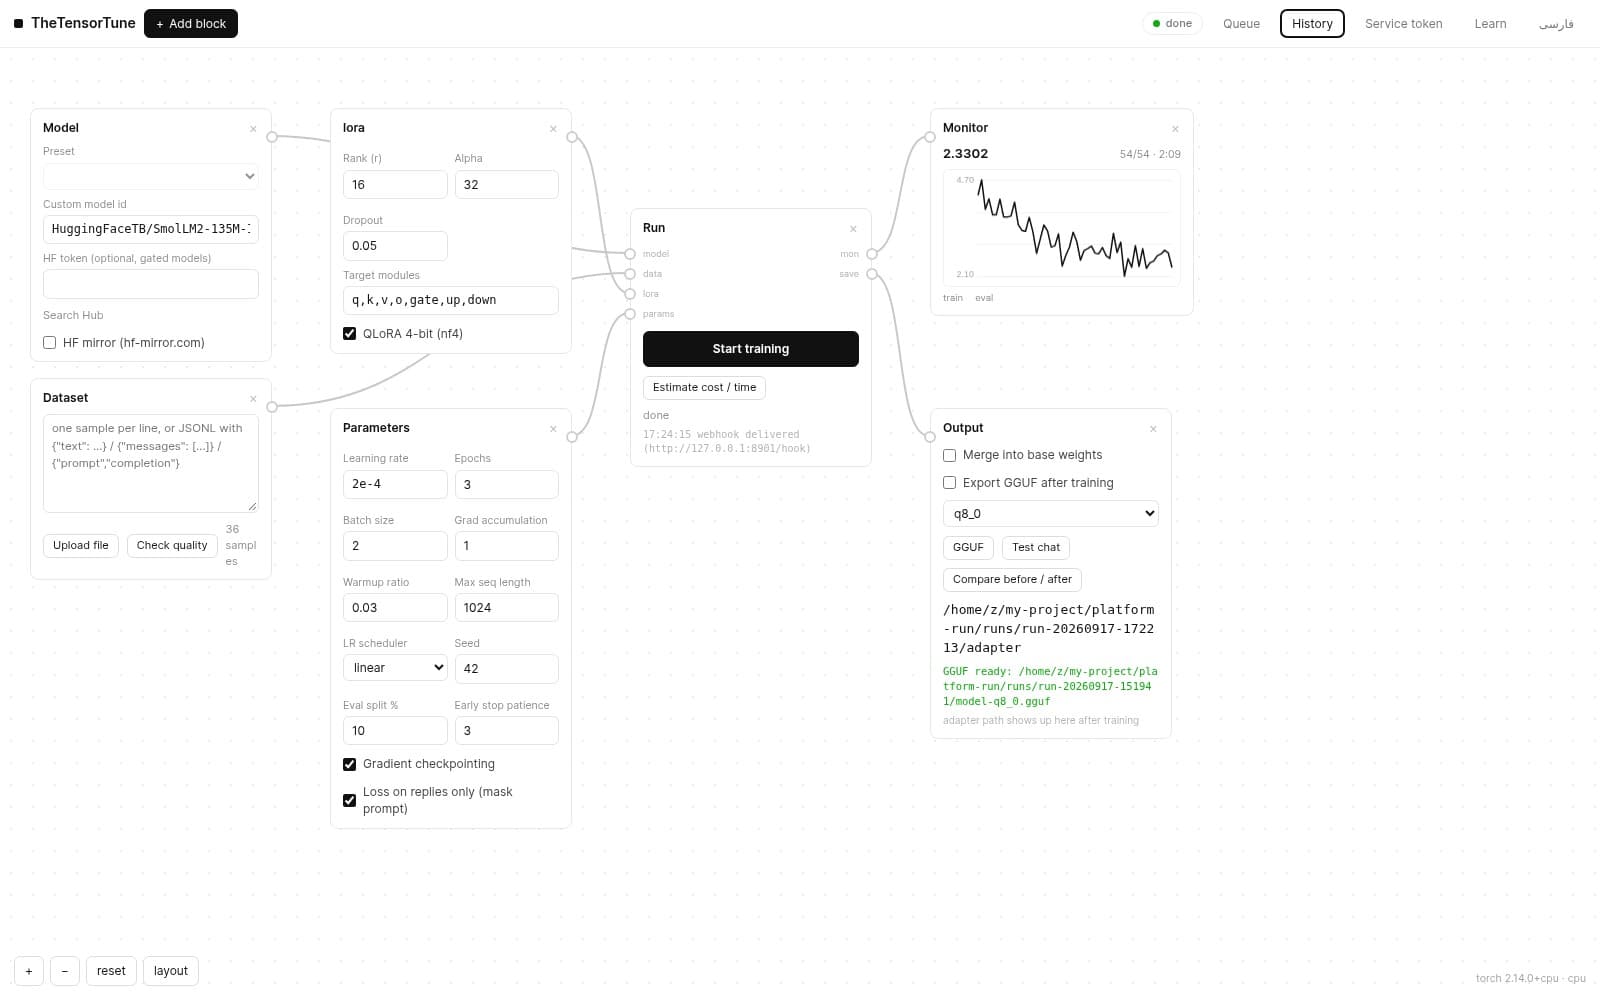
Совет: q8_0-экспорт даёт ответы, совпадающие с исходной моделью — токенизатор, архитектура и настройки attention сохраняются полностью.