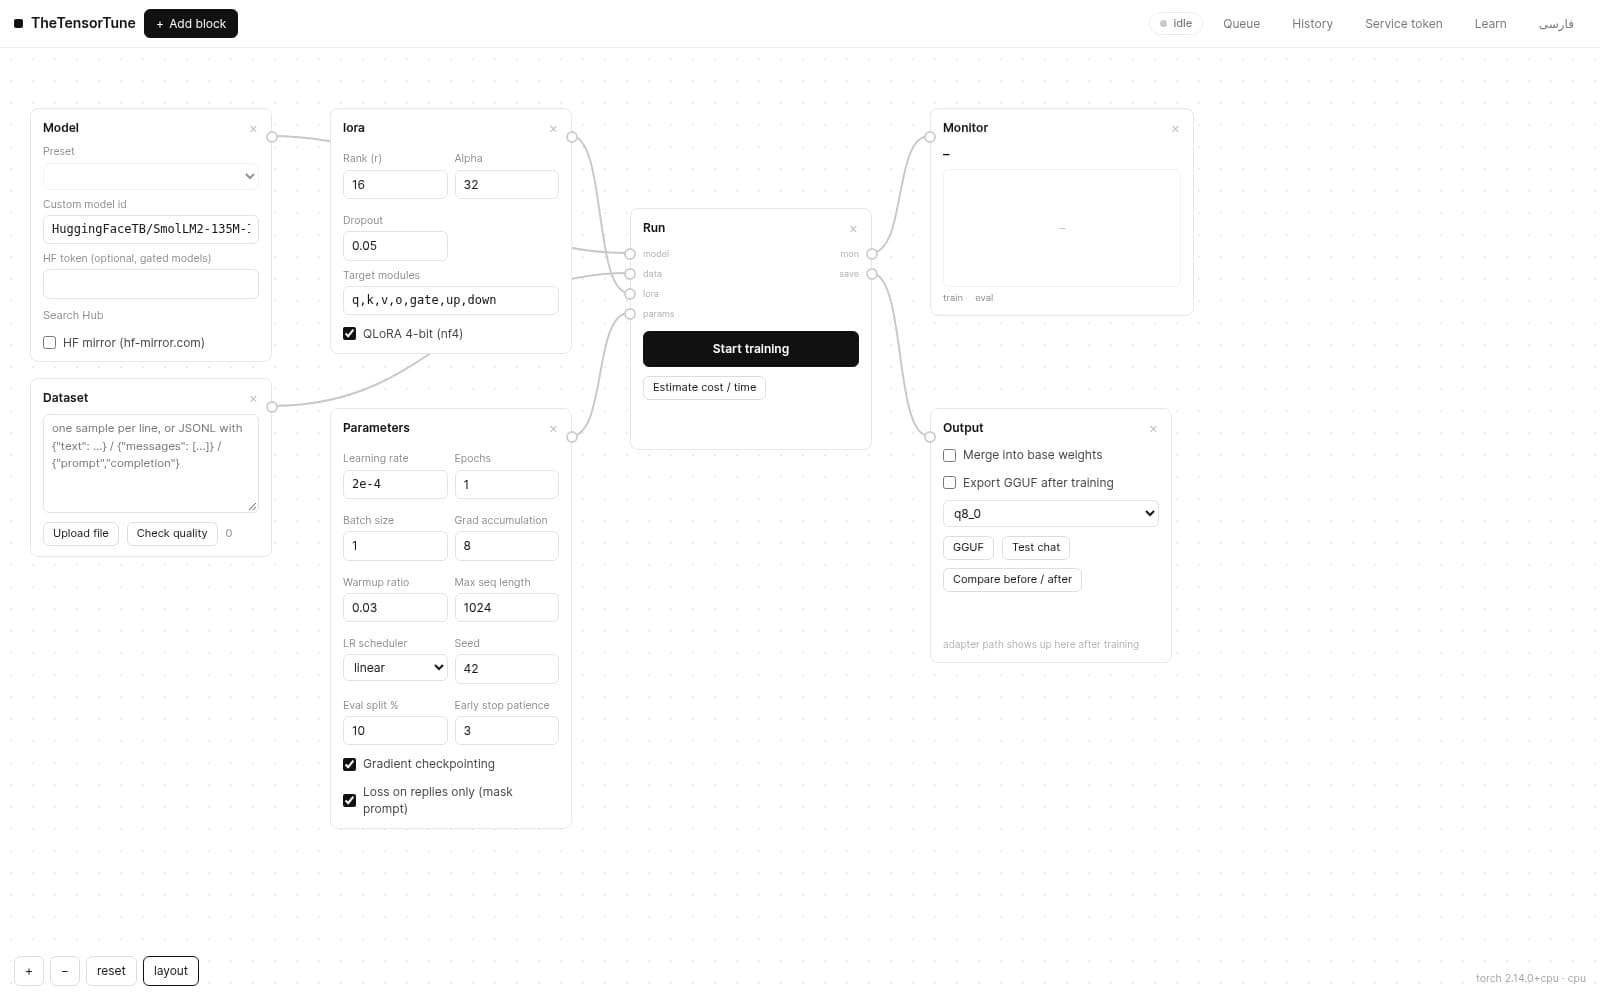
Блок LoRA определяет, какая часть модели и с какой ёмкостью обучается. Базовые веса заморожены; учатся только матрицы низкого ранга — поэтому памяти и диска нужно так мало.
- rank (r): ёмкость обучения; 8 для лёгких задач стиля, 16–32 для более сложного поведения. Больше r — больше адаптер.
- alpha: масштаб выхода LoRA; конвенция —
alpha = 2×r. - dropout: 0.05 — типичное значение, помогает на маленьких датасетах.
- targets: проекции внимания (q,k,v,o) плюс MLP (gate,up,down) — надёжный дефолт.
- QLoRA: грузит базу в 4 битах (NF4), чтобы большие модели помещались в меньший объём памяти.
Совет: с моделью 0.5B и r=8 обучается ~4–9 млн параметров — итоговый файл адаптера весит десятки мегабайт.