От адаптера до Ollama: экспорт от начала до конца
Разбор последней мили дообучения: что такое адаптер, что делает слияние, как выбрать квант и как заставить экспортированный файл работать в Ollama примерно за минуту.
Обучение собирает все лавры, но последняя миля дообучения — это экспорт: момент, когда ваша дообученная модель перестаёт быть папкой с артефактами тренировки и становится одним файлом, который можно передать другим инструментам. Этот пост проходит эту милю в TheTensorTune: что на самом деле происходит при нажатии GGUF, какой квант выбрать и как запустить результат в Ollama раньше, чем остынет чай.
Что у вас есть после обучения
Запуск LoRA не меняет базовую модель. Он пишет адаптер — небольшой файл низкоранговых матриц, обычно десятки мегабайт, в котором записано то, чему запуск научился. Базовая модель остаётся ровно такой, какой вы её скачали, и адаптер имеет смысл только рядом с ней. Поэтому в чате есть режим Merged: он применяет адаптер к базовым весам в памяти, чтобы вы говорили с объединённой моделью. И поэтому там есть режим Base — услышать «до» без окраски «после».
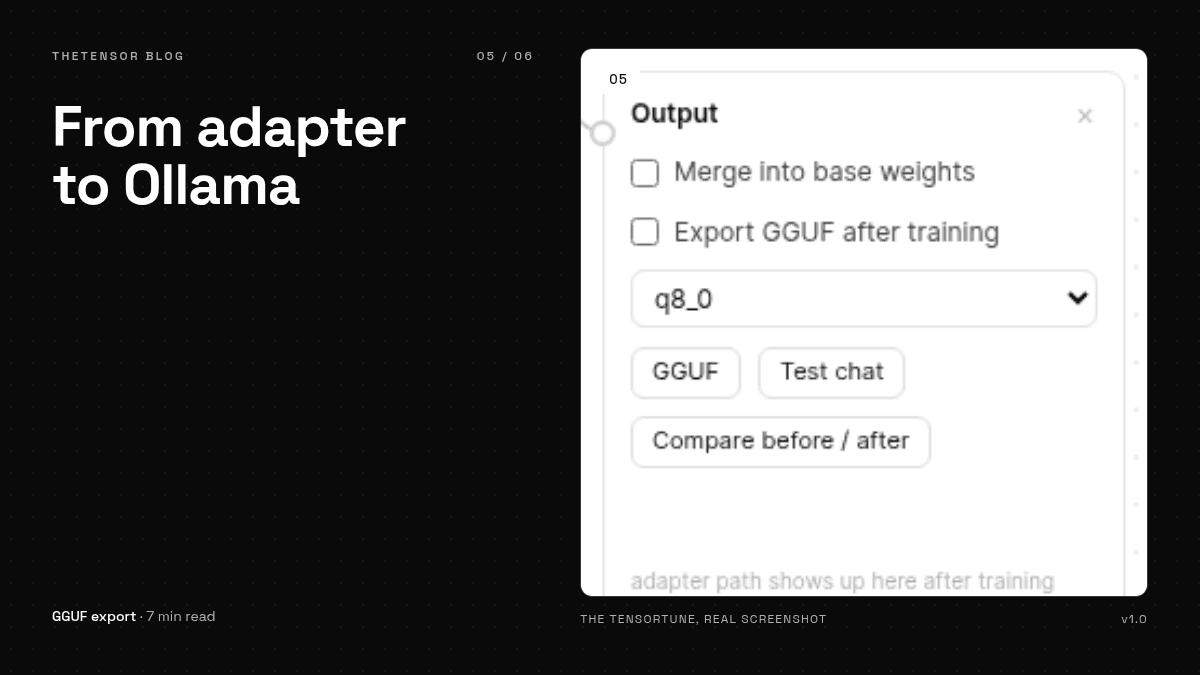
Адаптер плюс базовая модель — нормально внутри приложения, но остальной мир — Ollama, llama.cpp, LM Studio — говорит на языке одного файла. Этот файл — GGUF, и его создание — работа из двух шагов: слить адаптер в базовые веса, затем квантовать результат.
Выбор кванта
- f16 — точная копия слитых весов, самый большой файл. Берите, когда размер не важен и вы не хотите потерь сверх самого слияния.
- q8_0 — один байт на вес. Крошечная ошибка, файл сильно меньше. Рекомендуемый по умолчанию; наши демо-экспорты сделаны им.
- K-кванты (q4_k_m и компания) — примерно четверть размера f16 с небольшой платой качеством. Нужен llama-quantize: приложение найдёт его в PATH или через
TT_LLAMA_CPP.
Практичное решение такое: экспортируйте q8_0, поговорите с ним — и если ответы всё ещё совпадают с теми, что вы видели в приложении, всё. Спускайтесь к меньшему кванту, только когда размер файла прижал, — и тогда тестируйте заново: квантование меняет модели скучно-непредсказуемым и легко-заметным образом.
Сам экспорт
В блоке Output выберите квант и нажмите GGUF. Прогресс показывается тостом, а по завершении вы получаете путь к файлу и ссылку на скачивание. Файл ложится рядом с чекпоинтом запуска и называется по выбранному кванту. Экспорт сохраняет токенизатор, настройки архитектуры и конфигурацию attention — та самая неприметная часть, которая решает, будет ли экспортированная модель отвечать как проверенная. Неприметная и стоящая проверки: первое, что стоит сделать с экспортом, — задать ему тот же промпт, что в экране сравнения.
Минута до Ollama
# рядом с экспортированным файлом
cat > Modelfile <<EOF
FROM ./model-q8_0.gguf
EOF
ollama create my-tuned -f ./Modelfile
ollama run my-tuned
Вот и вся церемония. Ollama читает Modelfile, регистрирует модель под данным именем и обслуживает её как любую другую. С этого момента модель переносима настолько, насколько переносим один файл: скопируйте на другую машину, положите на шару, отдайте другу. Адаптер перестал быть проектом и стал вещью.
Хотите длинную версию любого шага — урок 11 встроенного курса разбирает экран экспорта подробно, а INSTALL.md документирует API-маршрут, делающий ту же работу из скрипта.