Как читать кривую loss
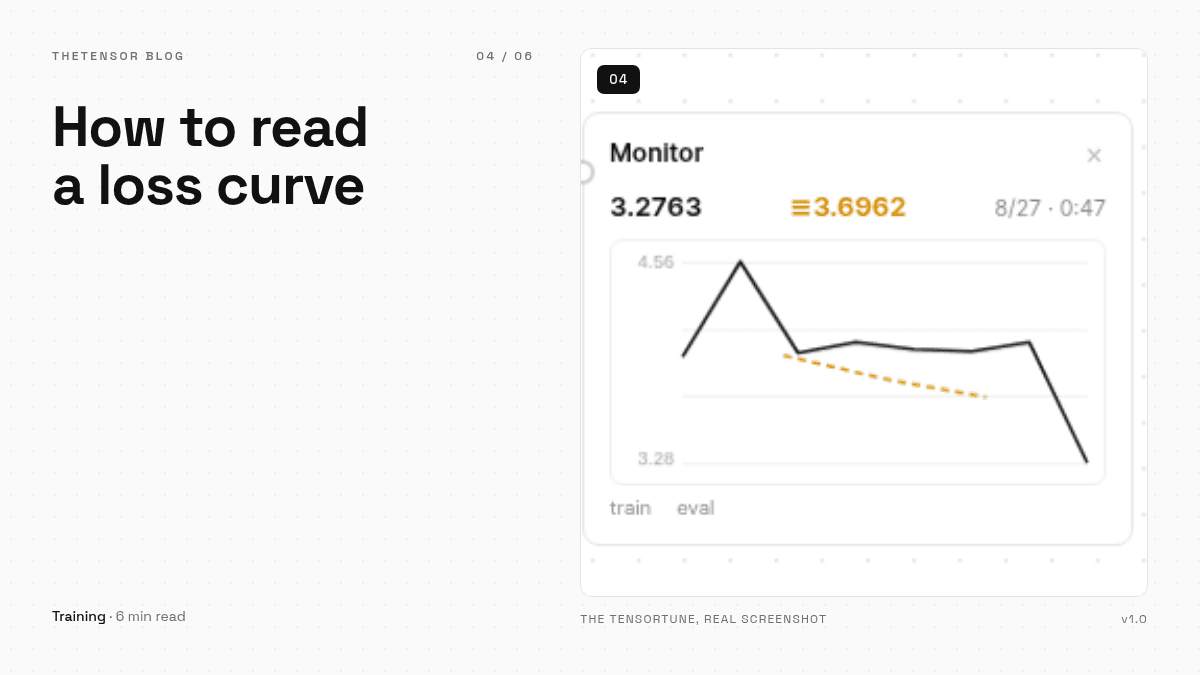
График loss — самый честный отчёт о тренировочном запуске. Как выглядит здоровая кривая, как выглядит взрыв learning rate, как рано поймать переобучение и зачем на самом деле нужен eval-сплит.
Когда вы жмёте Start в TheTensorTune, блок монитора начинает рисовать линию. Эта линия — самая информационно плотная штука во всём приложении, а людей обычно не учат, что с ней делать. Кривая loss — не счёт, а полный отчёт о запуске; и когда вы знаете четыре-пять сюжетов, которые она умеет рассказывать, запуск читается с одного взгляда.
Что это за линия
Loss — это удивление модели. На каждом шаге модель берёт батч ваших примеров, угадывает следующий токен и меряет, насколько ошиблась. Высокий loss — ошиблась сильно; низкий — предвидела ваш ответ. Обучение — это подталкивание нескольких миллионов чисел так, чтобы в следующий раз удивление было меньше. График в мониторе рисует точку на шаг, плюс вторую, пунктирную линию для eval-сплита — доли ваших данных, на которых модель никогда не учится, отложенной для честной проверки.
Здоровый сюжет
Здоровая кривая сначала падает быстро, потом выполаживается, подходя к полу. В одном из наших демо-запусков — маленькая instruct-модель на тридцати шести примерах саппорт-агента — loss обучения упал примерно с 4.0 до 1.4 за девяносто шагов, и eval loss пошёл следом. Такая форма значит: модель учит паттерны данных, а не точные слова, ведь eval-примеры ей не показывали. Когда пунктир идёт вниз вслед за сплошной линией — запуску можно верить.
Взрыв
Иногда кривая не падает — она лезет вверх или ломается в рваный зигзаг, который ухудшается с каждым шагом. Почти всегда это learning rate. Скорость обучения — это величина толчка: слишком маленькая — ничего не происходит, слишком большая — каждый шаг пролетает мимо, и модель становится хуже, а не лучше. Мы однажды поставили 1.0 во время тестов (не надо) и видели, как loss пошёл резко вверх. Для LoRA проверенное значение по умолчанию — 2e-4. Если кривую взорвало — уменьшите и начните заново: убитый запуск спасать не стоит.
Тихая ложь: переобучение
Коварнее сюжет, где сплошная линия продолжает падать, а пунктирная разворачивается и лезет вверх. Модель заучивает тренировочные примеры слово в слово, а на невиданных данных работает всё хуже. На маленьких датасетах — а это большинство датасетов для дообучения — это случается после пары эпох. Это не катастрофа, это информация: либо остановитесь здесь, либо срежьте число эпох. Ранняя остановка TheTensorTune сама следит за eval-линией и останавливает запуск, которому стало нечем улучшаться.
Ещё одно число заслуживает места на экране: перплексия, которую экран сравнения показывает для базовой и дообученной модели. Это loss, переведённый в «между сколькими словами модель в среднем колебалась» — чем ниже, тем увереннее. Наблюдать, как она падает с 55 до меньше 9 на eval-сплите нашего демо-датасета, было приятнее любого loss-числа, потому что мерили её на данных, которых модель никогда не видела. В этом весь смысл eval-сплита: он превращает ощущение в число.