LoRA по-человечески
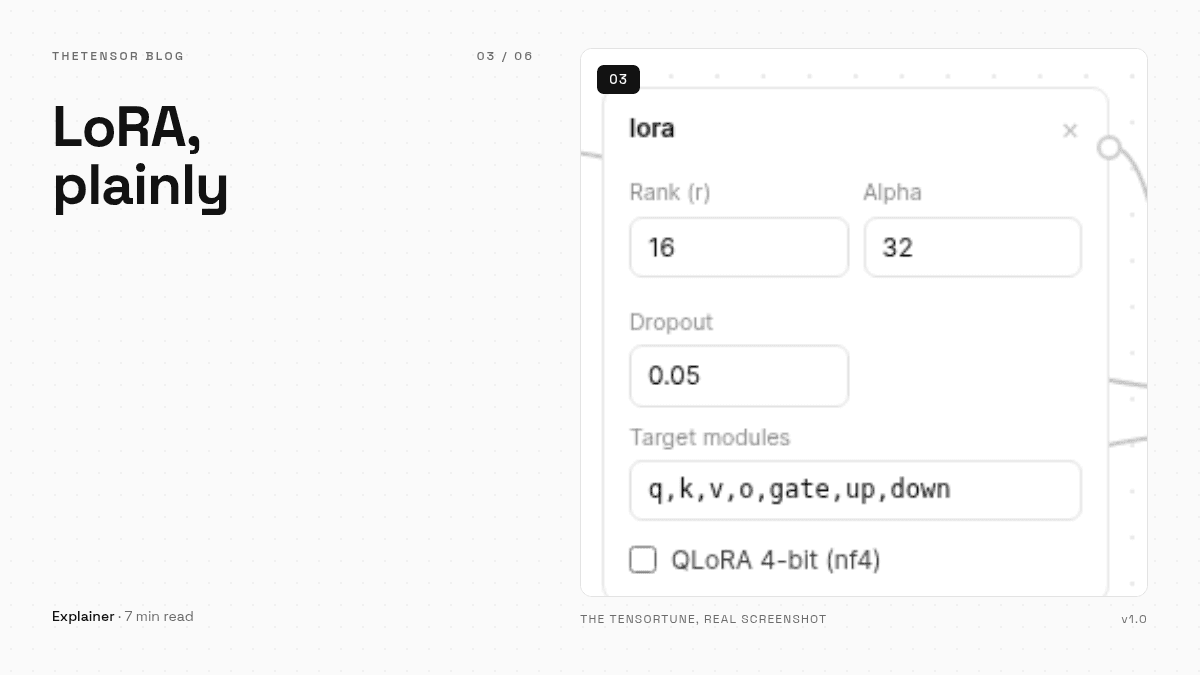
Что LoRA делает на самом деле, без математической мигрени: замороженная база, тонкий обучаемый слой и что меняют rank, alpha, dropout и целевые слои — плюс когда стоит включать QLoRA.
LoRA принято объяснять матрицами, ранговыми разложениями и ворохом нотации. Это полезно, если вы её реализуете, и бесполезно, если хотите дообучить модель сегодня после обеда. Вот рабочая версия — та, что умещается рядом с настоящими полями блока LoRA.
Суть в одном абзаце
Полное дообучение переписывает каждый вес модели — миллиарды чисел, гигабайты градиентов. LoRA ставит другую ставку: заморозьте исходные веса полностью и обучайте рядом маленькую пару матриц, чьё произведение приближает нужное вам изменение. Модель остаётся нетронутой. Обучение пишет тонкую накладку, и сохраняется только она. Поэтому запуску LoRA нужна малая доля памяти, а результат — файл адаптера в десятки мегабайт, а не копия всей модели.
Rank: сколько накладка может сказать
Ранг (r) — это ширина тех матриц: число независимых направлений, которые накладка способна выразить. Ранг 8 даёт компактную накладку для сдвигов тона, формата и стиля. Ранг 16–32 покупает место для более богатого поведения ценой большего адаптера и чуть большей памяти. На маленькой модели с r=16 вы обучаете примерно несколько миллионов параметров — около одного процента модели. Это и есть весь трюк: крошечная накладка, нетронутая база.
Alpha: громкость голоса
Alpha задаёт, насколько сильно вклад накладки примешивается к выходу модели. Клубная конвенция — alpha = 2 × r, поэтому пары 8/16 и 16/32 встречаются везде, включая нас. Тонкость, которую стоит знать: важно отношение alpha / r, а не любое из чисел по отдельности. Держите отношение около двух — и не промахнётесь. Когда захотите поэкспериментировать, крутить будете именно эту ручку.
Dropout и целевые слои
Dropout (0.05 — нормальное значение) случайно глушит части накладки во время обучения, чтобы она не заучивала датасет слово в слово. Больше всего он помогает на маленьких датасетах — то есть, будем реалистами, на большинстве датасетов для дообучения.
Целевые слои решают, куда накладка подключается. Набор по умолчанию покрывает проекции внимания (q, k, v, o) плюс MLP-блок (gate, up, down) — стандартный рецепт, с которым поставляется TheTensorTune. Узкий набор обучается быстрее, но выучивает меньше; значение по умолчанию — скучный надёжный выбор, а «скучный» в этой области — комплимент.
QLoRA: та же идея, коробка меньше
QLoRA сохраняет всё описанное, но грузит замороженную базу в 4 битах (NF4) вместо полной точности, так что модель, требовавшая много памяти, влезает в её долю. Адаптер вы обучаете тот же; база просто занимает меньше места, пока вы это делаете. Поставляется тумблером в блоке LoRA, а не значением по умолчанию: на маленьких моделях сжатие покупает меньше, чем стоит. Включайте, когда нужная модель больше имеющейся памяти.
Вот и весь LoRA без единой матрицы: число-ранг, ручка громкости, немного dropout и разумный набор слоёв. Поставьте r, удвойте для alpha — и тратьте оставшееся внимание на датасет: дообучение выигрывается именно там.