Почему мы сделали TheTensorTune
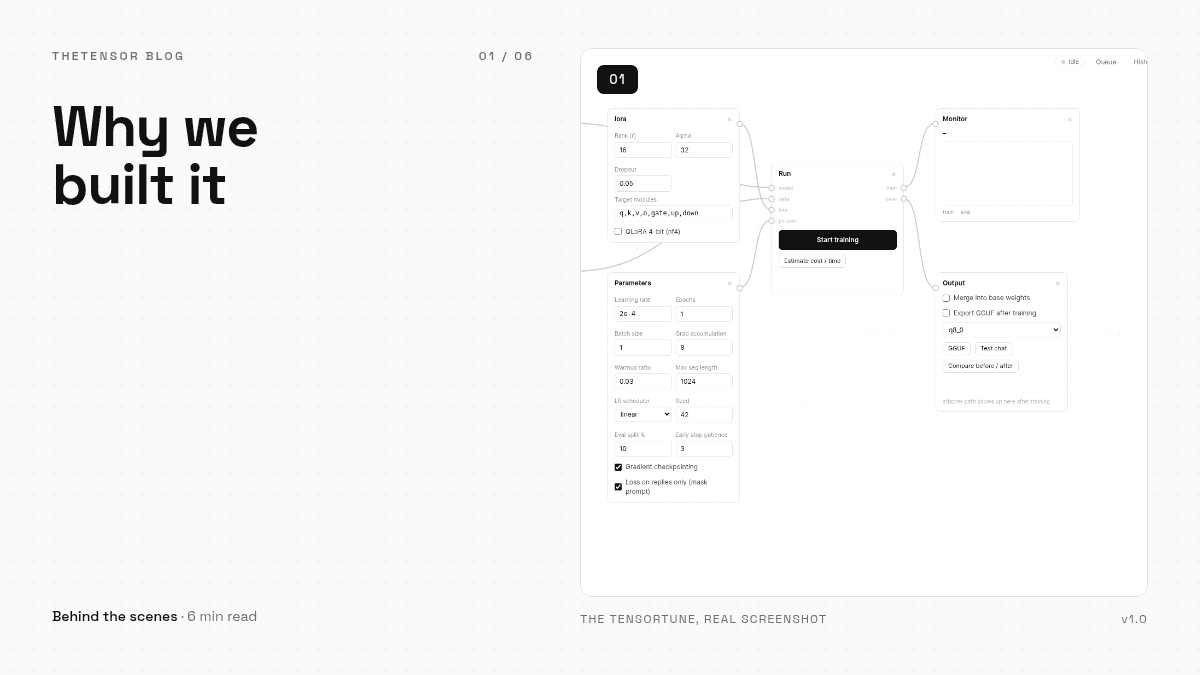
Честная история TheTensorTune: что раздражало нас в существующих инструментах дообучения, почему всё должно было уместиться в один Python-файл и что вошло в v1.0.
Каждый туториал по дообучению начинается одинаково: склонируйте репозиторий, поставьте вот эти четырнадцать вещей, скопируйте yaml, чините конфликт версий, поправьте ещё три файла — и потом, если ничего не сломалось, вы получаете полоску прогресса и ноль понимания, что оно делает с вашими данными. Мы прошли эти туториалы больше раз, чем способны сосчитать. Где-то около пятой убитой среды идея TheTensorTune перестала быть шуткой.
Целью никогда не была конкуренция с большими обучающими фреймворками — они хороши в своём. Целью было взять стандартный цикл — датасет, модель, настройки LoRA, обучение, оценка, экспорт — и сделать его тем, что можно увидеть и потрогать от начала до конца, не покидая вкладки браузера. Дообучение больше не редкий ритуал; для многих это обычное дело, и оно заслуживало рабочей среды, а не чек-листа.
Один файл — намеренно
Ограничение звучало глупо, когда мы записали его на бумагу: всё приложение — один Python-файл. Без структуры пакета, без сборки, без контейнерного образа. Причина практическая. Один файл легко прочитать, легко аудитить, легко скинуть на флешку и передать коллеге. Когда кто-то спрашивает «что это на самом деле делает с моими данными?», ответом может быть «открой файл и посмотри» — и такой ответ реально осилить за вечер чтения.
Ограничение ещё и удерживало нас в честных рамках. Каждая функция должна была заслужить место в файле. Если чему-то требовался микросервис или сервер БД — оно вылетало. Выжил тот цикл, который вы видите сегодня: холст из соединённых блоков, проверка качества датасета, обучение с живыми графиками, очередь с чекпоинтами, тестовый чат, сравнение до/после и экспорт GGUF. Каждая вещь отвечает на вопрос, который у человека реально возникает во время дообучения.
Что вошло в 1.0
- Рабочая среда — холст с графом блоков, на английском и полноценном персидском справа налево.
- Настоящее обучение — PEFT под капотом, с чекпоинтами, возобновлением и ранней остановкой.
- Ответы, а не артефакты — тестовый чат и сравнение бок о бок: модель, с которой нельзя поговорить, — это файл, а не результат.
- Экспорт, который работает — слияние и квантование в GGUF одним кликом, готово для Ollama и llama.cpp.
- Курс внутри приложения — двенадцать уроков со скриншотами, от первой загрузки до автоматизации через API.
Перед тегом 1.0 релиз прошёл пятьдесят тестовых сценариев — тридцать функциональных и двадцать сквозных, — плюс набор регрессий по безопасности: path traversal, SSRF, XSS, CSRF, обращение с токенами и укрепление загрузок. Это было скучно, и мы бы ни за что это не выкинули. Инструмент, который трогает ваши файлы и поднимает локальный сервер, обязан быть скучным ровно в тех местах, где это нужно.
Если вы уже дообучаете модели, нам кажется, среда покажется недостающим сокращением. А если вы никогда этого не делали — урок первый начинается с нуля и показывает всё по шагам. В любом случае расскажите, что сломалось: ссылки в футере.