节点图工作台
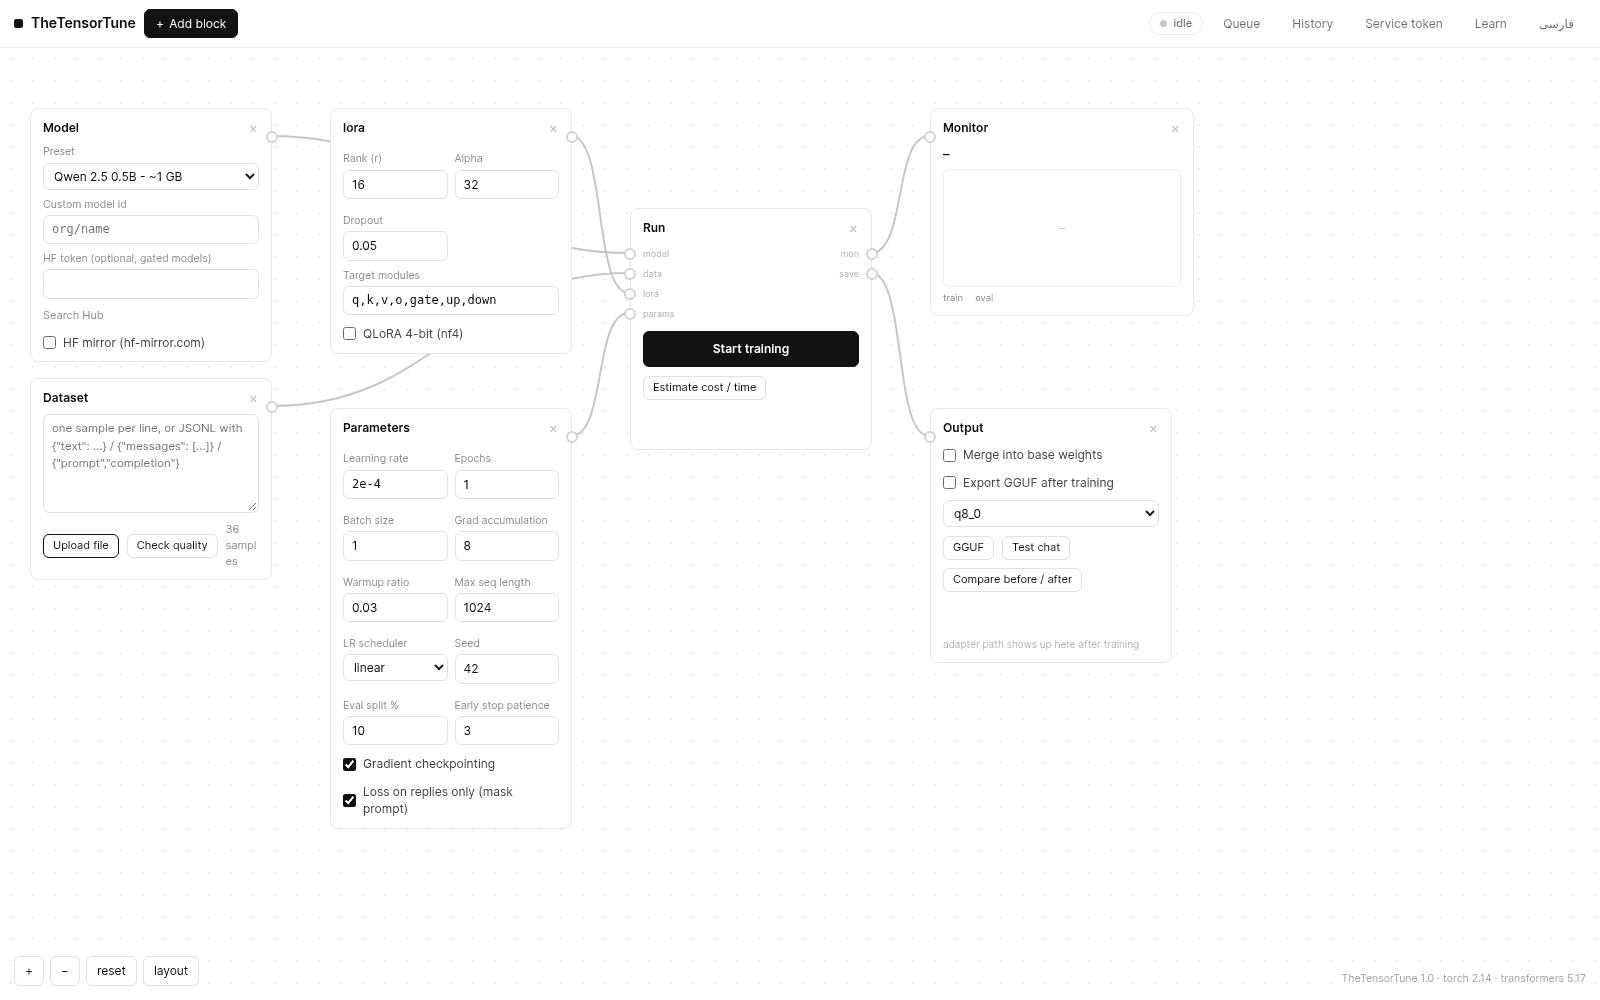
模型、数据集、LoRA、参数、输出——每个阶段都是画布上一个可拖动的方块。从一个端口拉线到另一个端口就能连接,整条流水线始终尽收眼底。
TheTensor 出品 · TheTensorTune v1.0
TheTensorTune 是一个跑在你自己机器上的工作台。带上数据集,选好模型,训练一个 LoRA 适配器,和结果对话,把它跟原模型对比,再导出一个能在 Ollama 和 llama.cpp 里跑的 GGUF 文件。没有账号,没有安装向导,任何数据都不离开你的电脑。
Apache-2.0 免费开源 · Windows、macOS 和 Linux · Python 3.10+
以下数字来自一次真实运行 · v1.0
01 · 这是什么
TheTensorTune 就是一个 Python 文件。运行它,浏览器里会打开一个工作台:一块画布,微调的每个阶段都是上面一个可以拖动、可以连线的方块。不用注册,不用配置控制台。应用和你的数据都只待在你自己的机器上,就这么多。
流程就是标准流程,只是不用跟终端打交道。你把数据带进来,程序在训练前先帮你检查它。你选一个模型、改几个设置——默认值对第一次运行来说已经是合理的。训练就在你眼前进行:用一张实时跳动的 loss 曲线代替刷屏的日志,途中还会自动存检查点。
一次运行结束后,大多数工具没做完的那部分就在这里:跟你刚训出来的模型聊几句,把它和基础模型并排摆放,从数字和文字两个层面看清差别,然后导出成一个文件,直接放进大家本来就在用的工具里。界面支持英语和波斯语,还有一套十二讲的图文教程装在应用里。
“一步操作如果能从终端命令变成画布上的方块,那它就该是方块。”
— TheTensor 开发日志,第 1 条
02 · 它能做什么
从「我有一点数据」到「我的模型跑在 Ollama 里」,TheTensorTune 替你包办十件事。
模型、数据集、LoRA、参数、输出——每个阶段都是画布上一个可拖动的方块。从一个端口拉线到另一个端口就能连接,整条流水线始终尽收眼底。
底层是货真价实的 PEFT,带检查点、断点续训和早停——不是演示模型。从预置模型起步,或者直接填任意 Hugging Face 模型 ID。
点一下就能看到样本数、格式构成、重复项、检测到的语言和长度直方图,让坏数据在改起来最便宜的阶段就被抓住。
开跑之前,估算器根据你真实的数据集和设置算出:这次训练装不装得下、要多久、花多少钱。
把多个任务排进队列,看着步数和实时 loss 走,干净地取消,再从检查点续上。任务之间自动释放内存。
跟你微调出的模型多轮对话,有 Adapter、Merged、Base 三种模式,训练到底改了什么,聊两句就知道。
基础模型和微调模型的困惑度、eval loss 并排摆着,同一个提示词两边各答一次。差别既体现在数字里,也体现在字里行间。
一键合并并量化为 f16、q8_0 或 K-quant。导出的文件保留分词器和元数据,回答跟你在应用里测的一模一样。
界面里的每个功能都有对应的 API 路由。异步任务完成时可以回调 Webhook,带 HMAC-SHA256 签名,发件人一验便知。
十二讲的图文教程就装在应用里,从第一次上传数据集到用 API 做自动化,英语和波斯语双语。
03 · 怎么用
全部旅程就是这些。每一步在教程区都有对应的一课,配着截图。
粘贴文本或上传文件:聊天记录、提示词/补全对,或者一行行的纯文本。「检查质量」会告诉你,你到底要拿什么去训练。
从预置列表起步,在应用里直接搜 Hugging Face Hub,或者手填 org/name。受限模型需要你的令牌,而它只待在内存里。
rank、alpha、学习率、轮数——每个设置都是方块里的一个字段,默认值在第一次运行时就能直接用。等有了理由再改。
按下 Start,loss 曲线实时画出来。往队列里加任务、取消任务,或者从检查点续跑,都行。
跟刚训好的模型聊聊,然后把它放到基础模型旁边:同一个提示词,两份回答,困惑度并排摆着。
一键合并、量化成一个 GGUF 文件。扔进 Ollama、llama.cpp 或 LM Studio,直接就能跑。
04 · 截图
下面每张图都是 TheTensorTune 1.0 实际跑起来时截的图——上传、训练、对话、对比、导出,一个不落。
05 · 常见问题
回答简短,不含糊。更长的版本在博客里。
TheTensor · TheTensorTune v1.0
压缩包里是一个 Python 文件和它的文档。装好依赖、运行文件,工作台就在浏览器里打开了。到第 3 课,几分钟内你就能开始第一次训练。
Apache-2.0 免费开源 · Windows、macOS 和 Linux · Python 3.10+