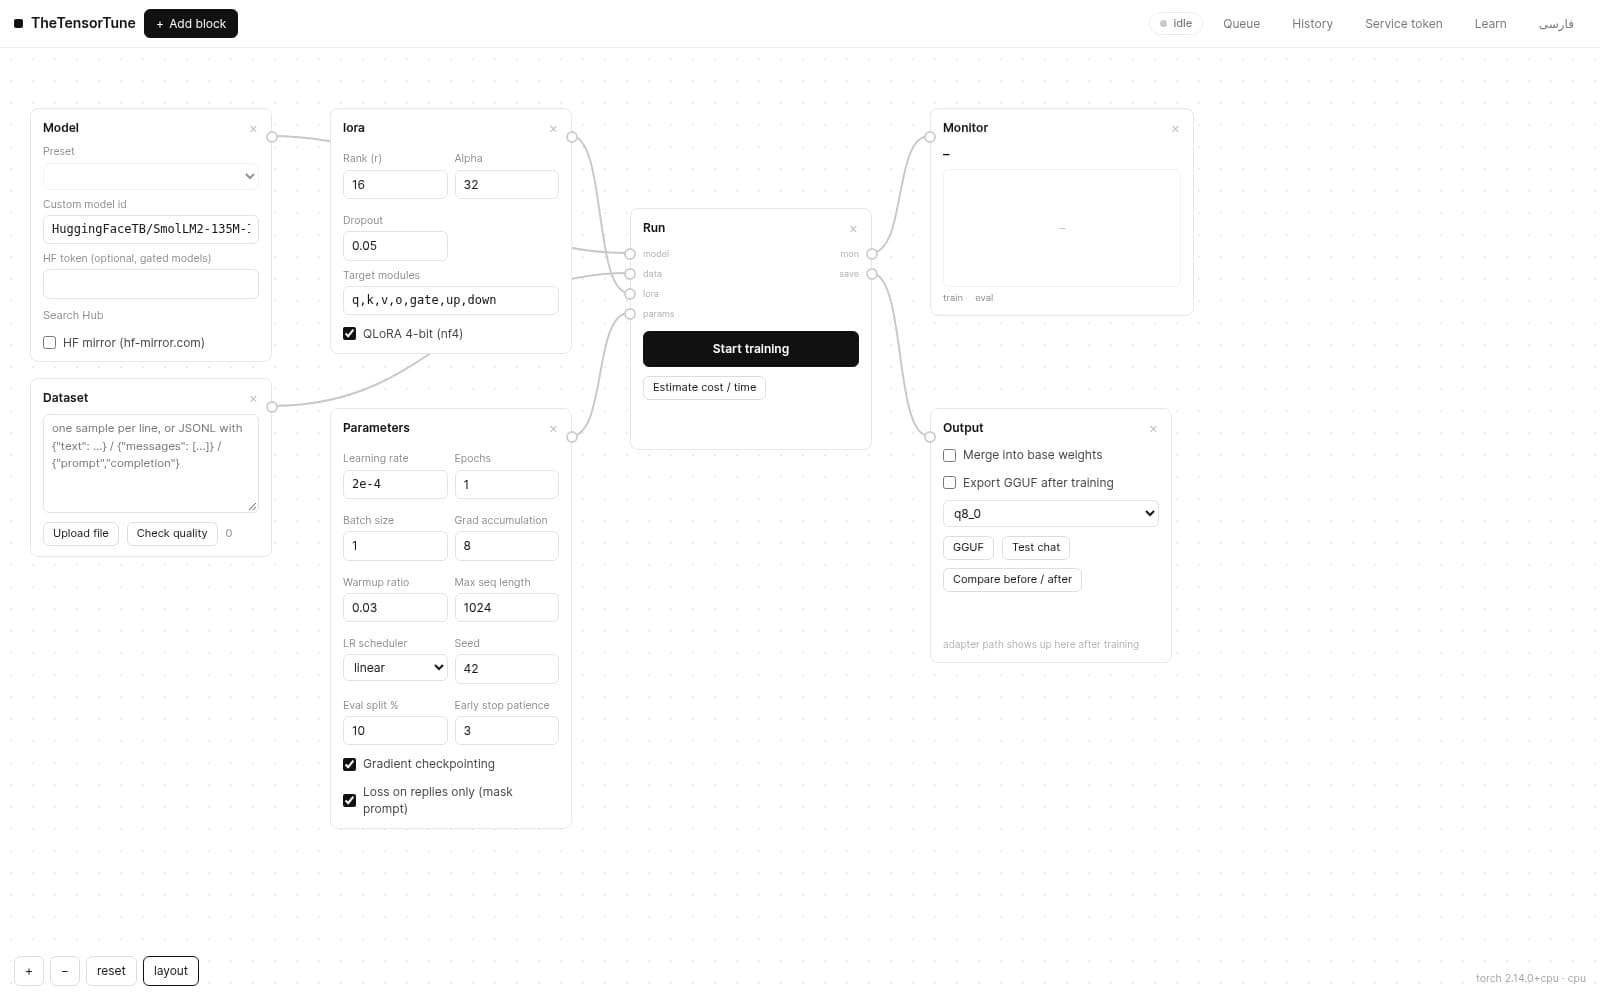
输出块(或历史里的运行行)上的 GGUF 按钮会合并模型,并在运行目录旁写出一个 .gguf 文件——可直接用于 llama.cpp / Ollama / LM Studio:
- quant:
f16(精确、大)、q8_0(低误差、小巧——推荐)和q4_k_m等 K-quant(需要 PATH 里有 llama-quantize 或设置 TT_LLAMA_CPP)。 - 导出进度显示在弹窗中;完成后给出文件路径和下载。
- 元数据完好:分词器、架构和注意力偏置全部保留——导出模型的回复与源模型一致。
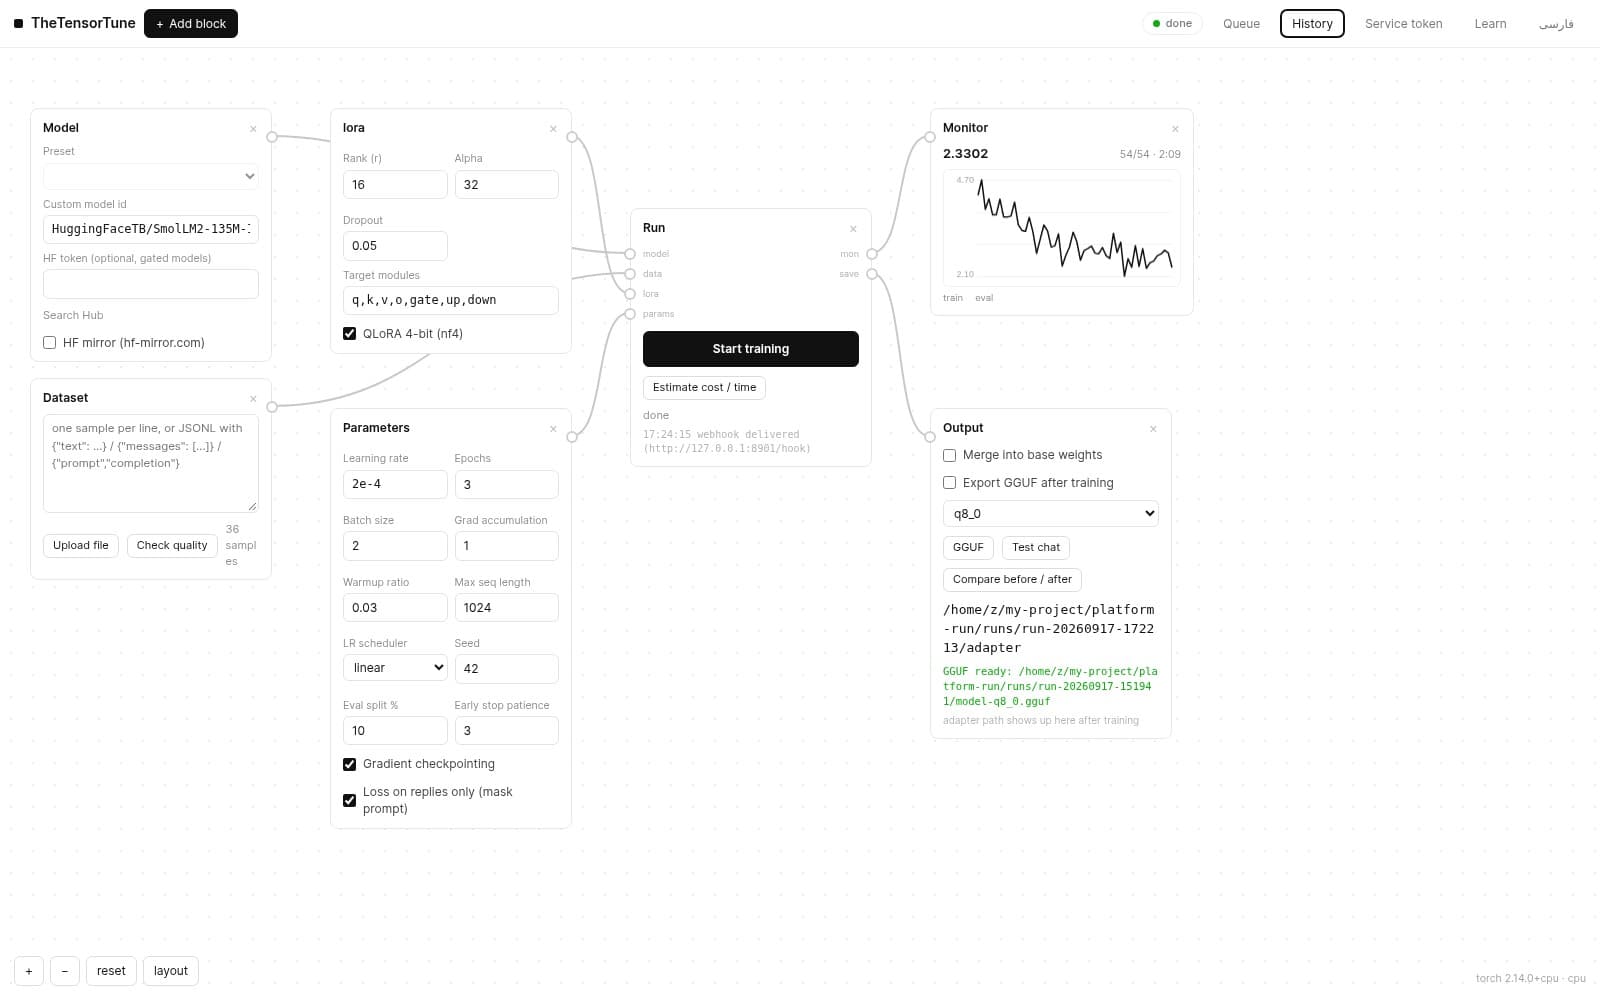
提示:q8_0 导出会保持与源模型一致的回复——分词器、架构和 attention 设置全部保留。