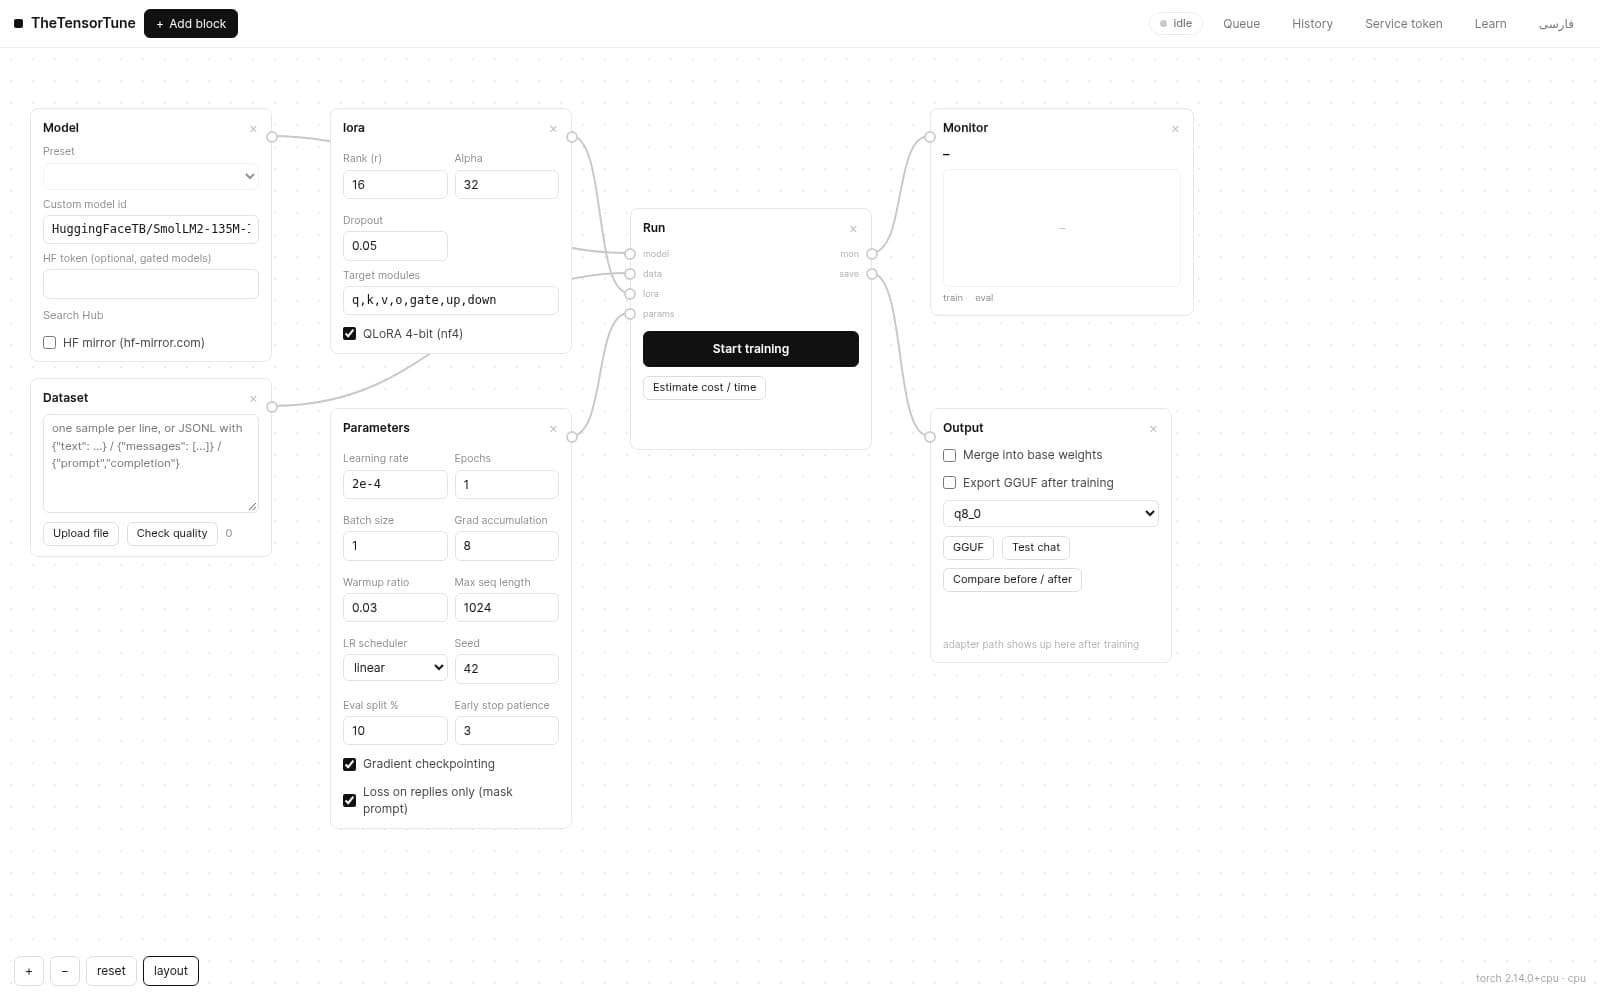
LoRA 块决定模型的哪一部分、以多大容量参加训练。基座权重保持冻结,只有低秩矩阵在学习——这就是为什么内存和磁盘需求都那么小。
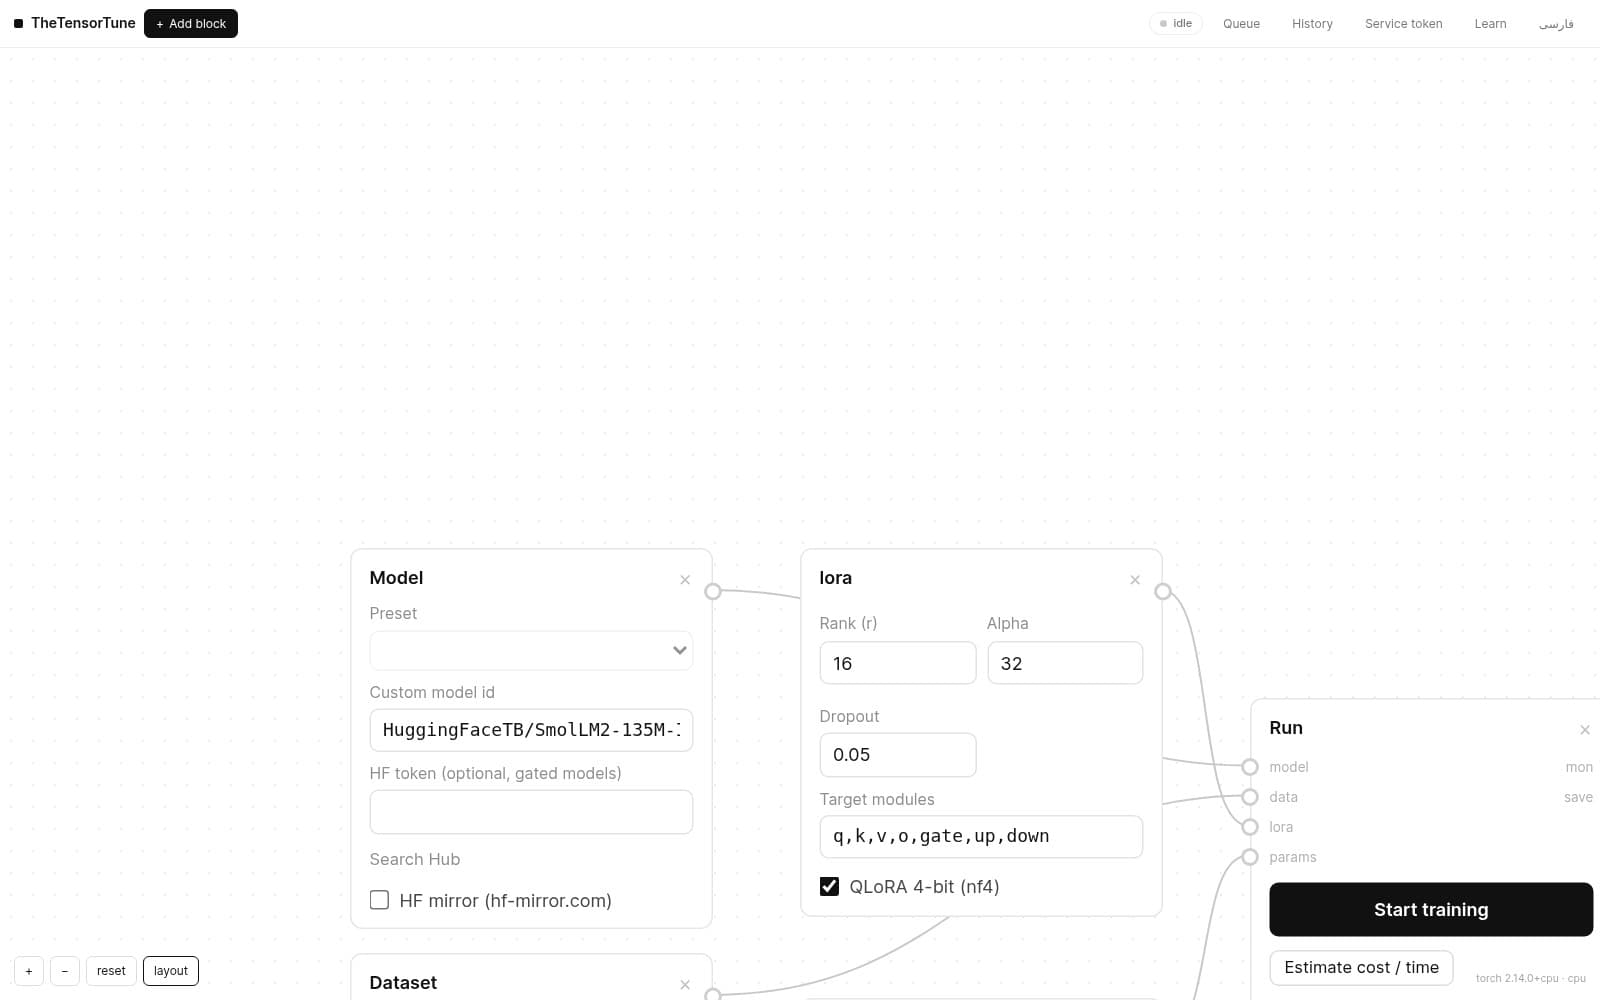
- rank (r):训练容量;轻量风格任务用 8,更丰富的行为用 16–32。r 越大,适配器越大。
- alpha:LoRA 通路的输出缩放;通用惯例是
alpha = 2×r。 - dropout:0.05 是常规值,小数据集上有帮助。
- targets:注意力投影(q,k,v,o)加 MLP(gate,up,down)——可靠的默认值。
- QLoRA:以 4 比特(NF4)加载基座模型,让更大的模型占更少的内存。
提示:0.5B 模型配 r=8 约有 400–900 万可训练参数——最终适配器文件几十 MB。