数据集是一份承诺
8 分钟阅读深度文章
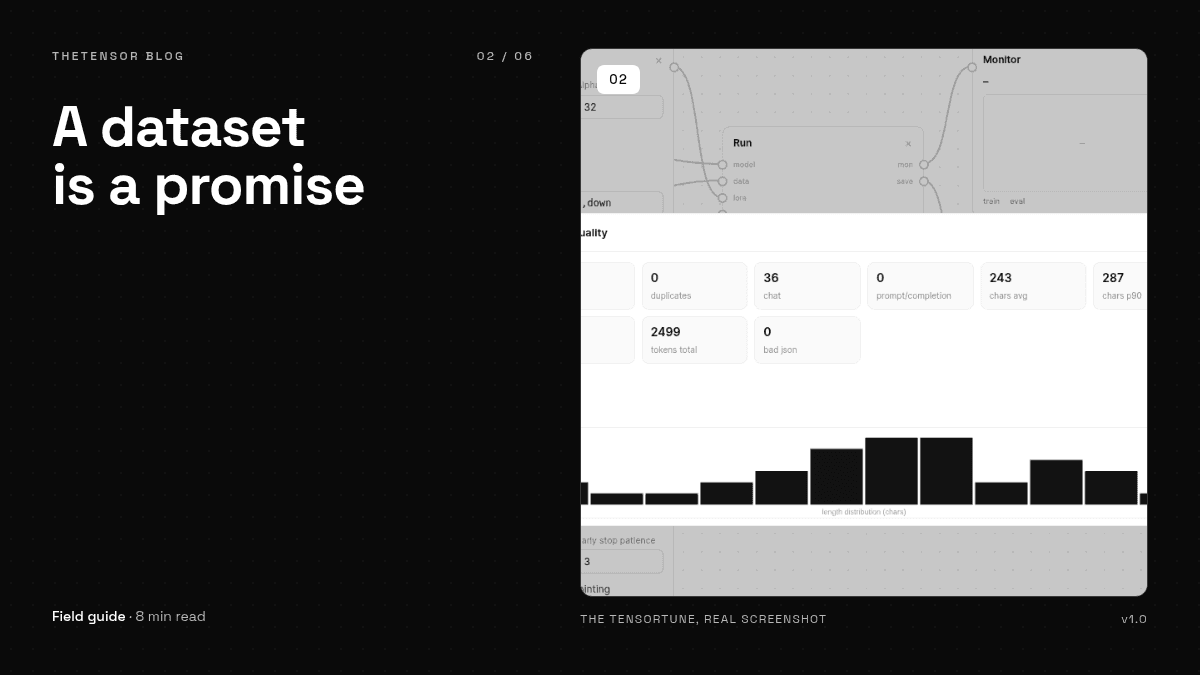
你放进数据集的每一条,都是在承诺模型变成那个样子。格式、现实的大小预期、以及怎么在浪费任何一个轮数之前读懂质量报告。
没有人因为 dropout 选错而微调失败;倒有很多人,因为数据集是二十条几乎一样的样本加一部四万字的小说而失败。这是我们在做数据集方块和质量报告的过程中学到的、简短而带刺的版本——外加那个能让一切归位的心智模型:数据集是一份承诺。每条样本都在对模型说「照这样回答」。样本之间互相打架,或者和你真正想要的东西打架,模型就会忠实地兑现这份破承诺。
三种格式,三种意图
- 聊天——
{"messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}]}。推荐的默认格式。只有助手轮会被训练,所以模型学的是回答,不是提问。 - 提示词 / 补全——
{"prompt":"...","completion":"..."}。用于转换类任务:修这段文字、分类这个、展开这个缩写。 - 自由文本——
{"text":"..."}或任意一行。用于给原始语料做风格迁移。不强加结构;一致性全靠你自己。
格式不是技术细节——它决定你承诺的是什么。聊天样本教模型如何回应某个人;提示词/补全教它完成某个特定转换;自由文本教它听起来像谁。不小心混进一个数据集,它们就搅成一份模型守不住的承诺——所以质量报告才会在训练前展示格式构成。
要多大?比你以为的小
互联网暗示你需要几千条样本。对 LoRA 来说这根本不成立。二十到几百条挑得好的样本就能大幅搬动语气和格式——这正是这个方法的全部魅力。我们的演示数据集是三十六条虚构宽带运营商客服的聊天样本,训练结束时,模型每条回答都签着同样的落款,用同样干脆友善的口吻。重要的不是数量。一致性:样本对「谁在说话」意见一致。覆盖面:你想接住的场景都接住了。诚实:回答代表你真正想要的,而不是你希望自己能做到的。
读质量报告
按下检查质量,报告会给你事实;其中四个值得最先看。
- 重复项——通往「一句话说得完美、永远只说这一句」的捷径。训练前去重。
- 长度直方图——超过
maxlen的样本会被截断。数据如果住在图表右端,要么提高 maxlen,要么把样本拆开。 - 语言构成——检测到的语言,包括波斯语和 emoji。冒出意外语言通常是粘贴出错的信号。
- 格式构成——哪些按聊天解析、哪些按提示词/补全、哪些退回了自由文本。无声的回退,正是训练惊吓的来源。
eval 切分:给自己留一份承诺
把 eval_pct 设在 10 到 20 之间,最干净的样本就成了你的证据。对比页在模型从没训练过的数据上测困惑度——这是判断微调有没有生效的唯一诚实办法。eval 切分设零很诱人(数据变多了!),但那等于让你靠感觉飞行。这整个练习的意义就是把感觉换成数字,而这恰恰是菜单上最便宜的一个数字。
只记一条的话记这条: 数据集里的每条样本,都应该是你愿意从成品模型嘴里听到的回答。不愿意,它就不该出现在文件里。
#数据集#质量#指南