从适配器到 Ollama:导出的完整最后一公里
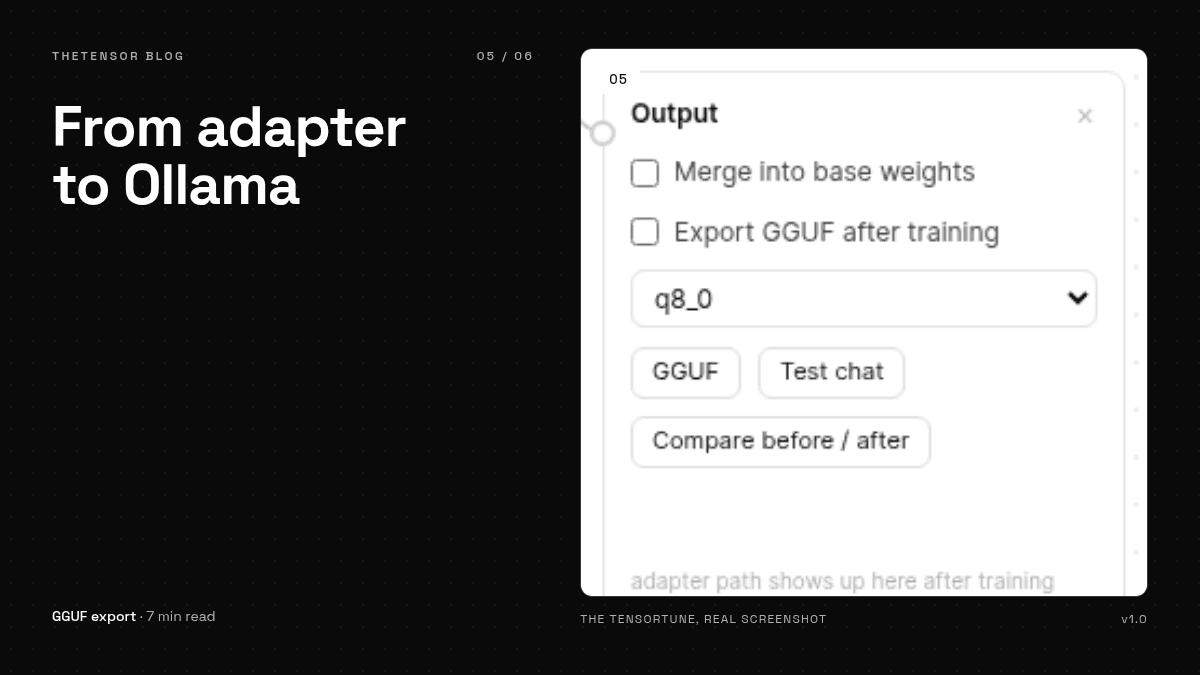
微调的最后一公里:适配器是什么、合并干了什么、量化怎么选,以及怎么在一分钟内让导出的文件在 Ollama 里跑起来。
风光都被训练占了,可微调真正的最后一公里是导出——你的模型从一目录训练残骸变成一个能递给其他工具的单文件的那一刻。这篇把这一公里在 TheTensorTune 里走一遍:按下 GGUF 之后实际发生了什么、量化怎么挑、以及怎么在茶凉之前让结果在 Ollama 里跑起来。
训练完你手里有什么
一次 LoRA 运行不会改动基础模型。它写出一个适配器——一个由低秩矩阵组成的小文件,通常几十 MB,里面装着这次运行学到的东西。基础模型保持你下载时的原样,适配器只有和它放在一起才有意义。这也是聊天里有 Merged 模式的原因:把适配器在内存里应用到基础权重上,让你直接和合并后的模型对话。也是 Base 模式存在的原因——听「之前」的时候别被「之后」染色。
在应用里,适配器加基础模型就够了;但外面的世界——Ollama、llama.cpp、LM Studio——只说一种语言:单文件。这个文件就是 GGUF,而造它只需要两步:把适配器合并进基础权重,然后把结果量化。
挑量化
- f16——合并权重的精确副本,文件最大。体积不敏感、除了合并本身不想要任何损失时选它。
- q8_0——每个权重一个字节。误差极小,文件小得多。这是推荐的默认值,我们的演示导出用的也是它。
- K-quant(q4_k_m 之流)——体积约为 f16 的四分之一,付一点质量。需要 llama-quantize,应用会从 PATH 或
TT_LLAMA_CPP找到它。
实用的决策法:导出 q8_0,跟它聊聊,回答还和你在应用里看到的一致,就完事了。只有在文件大小逼得没办法时才往下换更小的量化——换了就重新测一遍,因为量化对模型的改变预测起来无聊、注意起来容易。
导出本身
在输出方块里选好量化,按 GGUF。进度以浮条形式显示,结束后给你文件路径和下载链接。文件落在那次运行的检查点旁边,名字来自你选的量化。导出保留分词器、架构设置和 attention 配置——正是这块其貌不扬的部分决定了导出的模型回答起来像不像你测过的那个。其貌不扬,但值得一验:导出后的第一件事,就是把对比页用过的那个提示词再问它一遍。
一分钟到 Ollama
# 在导出文件旁边
cat > Modelfile <<EOF
FROM ./model-q8_0.gguf
EOF
ollama create my-tuned -f ./Modelfile
ollama run my-tuned
全部仪式就这些。Ollama 读取 Modelfile,用你起的名字注册模型,然后像侍弄其他模型一样侍弄它。从这刻起,这个模型拥有和一个文件一样的可携带性:拷到另一台机器、放上共享盘、发给朋友。适配器不再是一个项目,它成了一件东西。
哪一步想要长版,内置教程的第 11 课详解导出界面,INSTALL.md 记录了从脚本干同样活的 API 路由。