LoRA,讲成人话
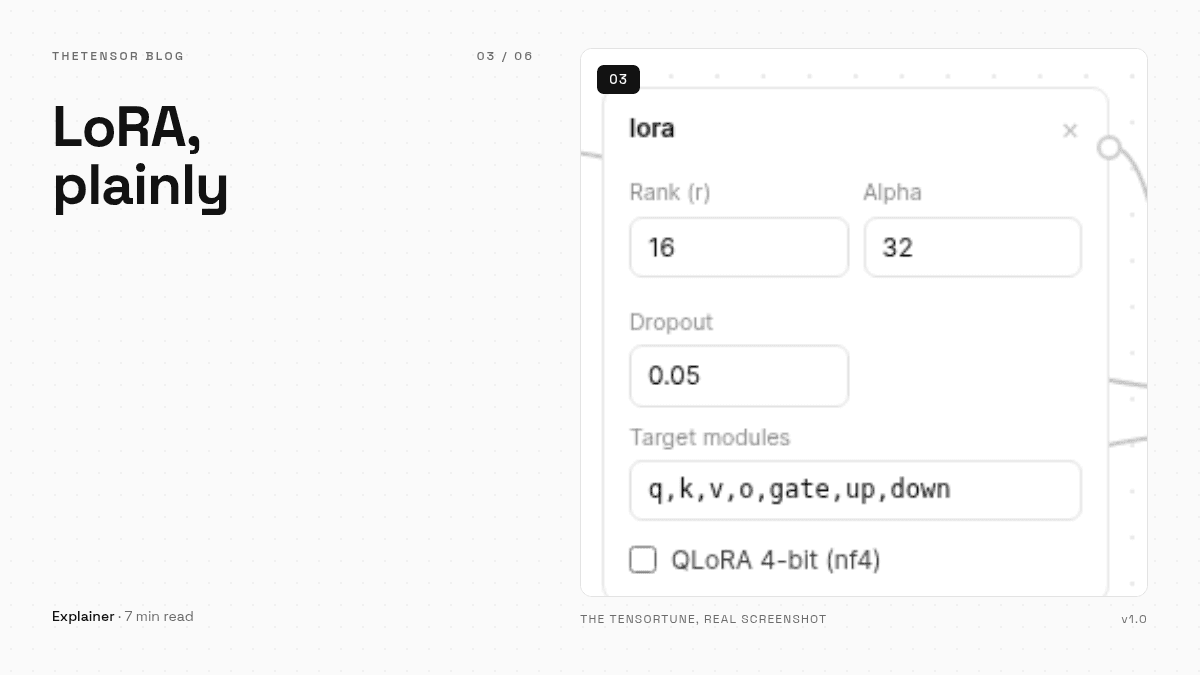
LoRA 到底做了什么,不犯数学头疼:冻结的基础权重、一层薄薄的可训练贴片,以及 rank、alpha、dropout、目标层各自拧动什么——还有什么时候值得开 QLoRA。
讲 LoRA 通常配矩阵、秩分解和一大堆符号。你如果是要实现它,这些有用;你如果只是想今天下午微调一个模型,这些没用。下面是工作版——就放在 LoRA 方块真实字段旁边的那一版。
核心思想,一段讲完
全量微调会重写模型里的每一个权重——几十亿个数字、几个 GB 的梯度。LoRA 换了个赌法:把原始权重整个冻结,在旁边训练一小对矩阵,让它们的乘积去逼近你想要的那个改动。模型本体纹丝不动,你的训练只写一层薄薄的贴片,而存盘的只有这层贴片。这就是为什么 LoRA 运行只要几分之一的内存,产出是几十 MB 的适配器文件,而不是一份完整的模型拷贝。
秩:贴片能说多少话
秩 (r) 就是那对矩阵的宽度——贴片能表达多少个独立方向。秩 8 给你一块适合语气、格式和风格迁移的紧凑贴片;秩 16 到 32 换来更丰富行为的空间,代价是更大的适配器和多一点内存。小模型配 r=16,你训练的大约是几百万参数——约为模型的百分之一。这个比例就是全部诀窍:贴片小,底盘不动。
alpha:嗓门多大
alpha 决定贴片的贡献以多大力度混进模型输出。社区惯例是 alpha = 2 × r,所以 8/16、16/32 这样的组合到处都是,我们也一样。值得知道的细节是:起作用的是 alpha / r 的比值,不是哪个数单独。比值保持在 2 附近就不会出大错。哪天想实验了,拧的就是这只旋钮。
dropout 和目标层
dropout(0.05 就挺好)在训练中随机让贴片的一部分闭嘴,免得它把数据集逐字背下来。它在小数据集上最有用——说句实话,大多数人微调用的小数据集。
目标层决定贴片插在哪儿。默认集合覆盖注意力投影(q、k、v、o)加上 MLP 块(gate、up、down)——标准配方,也是 TheTensorTune 的出厂设置。更窄的集合训练更快但学得更少;默认是那个无聊而可靠的选择,而「无聊」在这个行当里是夸奖。
QLoRA:同一个思路,更小的盒子
QLoRA 保留上述一切,只是把冻结的基础模型用 4 比特(NF4)加载,替代全精度。原本需要很多内存的模型,现在一小块就装下了。你训练的还是同一块贴片,只是底盘在训练期间占的地方小了。它以开关的形式放在 LoRA 方块里而不是默认打开,因为对小模型来说这点压缩得不偿失。当你想要的模型比你的内存大时再打开它。
这就是不带一个矩阵的 LoRA:一个秩、一只音量旋钮、一点 dropout、一套讲理的层。设好 r,alpha 翻倍,然后把剩下的注意力全花在数据集上——微调的胜负是在那里分出来的。