我们为什么做 TheTensorTune
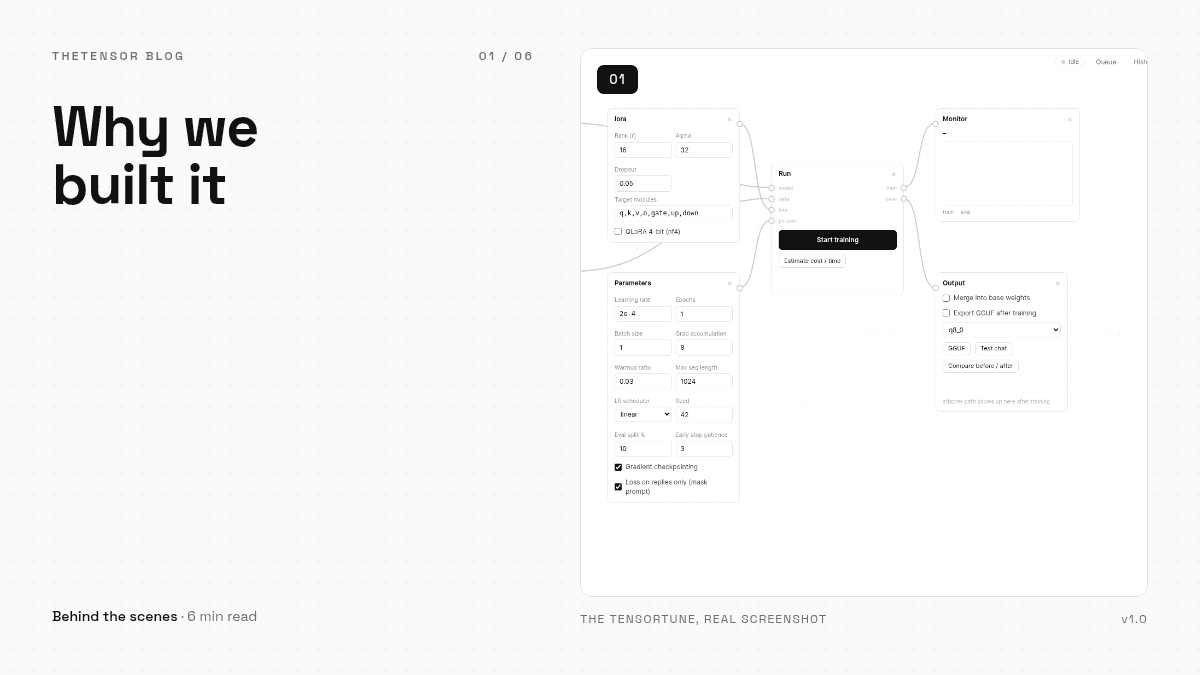
TheTensorTune 背后的实话:现有微调工具哪里让我们难受、为什么整个东西必须塞进一个 Python 文件、以及 v1.0 里到底装了什么。
每一篇微调教程的开头都一样:克隆这个仓库,装这十四样东西,抄这份 yaml,修版本冲突,再改三个文件,然后——如果什么都没坏——你会得到一根进度条,并且完全不知道它对你的数据做了什么。这种教程我们跟了一遍又一遍,数都数不清。大约在第五个被搞坏的环境之后,TheTensorTune 这个主意就不再是玩笑了。
目标从来不是和大型训练框架抢地盘,它们在本职上做得很好。目标是把标准流程——数据集、模型、LoRA 设置、训练、评估、导出——变成一件从头到尾看得见摸得着的事,而且不用离开浏览器标签页。微调早已不是什么稀有仪式,对很多人来说它就是一件日常事务,它值得一个工作台,而不是一张待办清单。
一个文件,是刻意的
这条约束写下来的时候听着挺傻:整个应用就是一个 Python 文件。没有包结构,没有构建步骤,没有容器镜像。但理由很实际。单文件好读、好审计,也容易拷进 U 盘递给同事。当有人问「它到底对我的数据做了什么」,答案可以是「打开文件自己看」——而这个答案真的能在一个下午的阅读里兑现。
这条约束也让我们在范围上保持诚实。每个功能都得在文件里挣到自己的位置。哪样东西需要微服务或数据库服务器,哪样东西就被砍掉。活下来的是你今天看到的流程:一张连着线的方块画布、数据集质量检查、带实时图表的训练、带检查点的队列、测试对话、前后对比和 GGUF 导出。每一件都对应着微调时人们心里真实冒出的一个问题。
1.0 版装了什么
- 工作台——每个阶段一个方块的节点图画布,英语和完整从右到左的波斯语。
- 真实训练——底层是 PEFT,带检查点、续训和早停。
- 给答案,不只是给产物——测试对话和并排对比。一个没法对话的模型只是个文件,不是结果。
- 能跑的导出——一键合并并量化成 GGUF,直接进 Ollama 和 llama.cpp。
- 装在应用里的课程——十二讲带截图,从第一次上传到 API 自动化。
打 1.0 标签之前,这个版本跑过了五十个测试场景——三十个功能测试、二十个端到端测试——外加一套安全回归,覆盖路径穿越、SSRF、XSS、CSRF、令牌处理和上传加固。这部分不好玩,但绝不会省。一个会碰你文件、会起本地服务器的工具,就该在关键的地方乏味。
如果你已经在微调模型了,我们觉得这个工作台会像一块你一直缺的捷径。如果你从没做过,第一课从零开始,带着你一步步走。不管哪种,坏哪儿了告诉我们——链接在页脚。